
ফেসবুকে কোনো পোস্ট খুব দ্রুত বিশ্বাসযোগ্য হয়ে উঠতে পারে। পরিচিত কারও শেয়ার, সংবাদমাধ্যমের মতো লোগো, সঙ্গে একটি স্ক্রিনশট—আর নিচে কয়েক হাজার প্রতিক্রিয়া। এত কিছু একসঙ্গে দেখলে সন্দেহ করার কারণ খুঁজে পাওয়া কঠিনই হয়।
সমস্যা হলো, এর কোনোটিই তথ্যটির সত্যতার প্রমাণ নয়।
অনলাইনে ভুল তথ্য অনেক সময় একেবারে বানানো হয় না। আসল ছবি ভুল ঘটনার সঙ্গে জুড়ে দেওয়া হয়, পুরোনো খবর নতুন বলে ছড়ায়, গবেষণার একটি বাক্য বাড়িয়ে বলা হয়, কিংবা সত্যিকারের কোনো নোটিশ থেকে এমন অংশ কেটে দেখানো হয় যাতে অর্থটাই পাল্টে যায়।
এই জায়গায় SIFT source evaluation কাজে লাগে। পদ্ধতিটি আপনাকে প্রতিটি ওয়েবসাইট নিয়ে গোয়েন্দাগিরি করতে বলে না। বরং কয়েকটি সহজ অভ্যাস শেখায়—দ্রুত সিদ্ধান্ত না নেওয়া, উৎসটিকে একটু দূর থেকে দেখা এবং দরকার হলে মূল তথ্যের কাছে ফিরে যাওয়া।
SIFT বলতে আসলে কী বোঝায়?
SIFT-এর পেছনে আছেন ডিজিটাল তথ্য যাচাই নিয়ে কাজ করা Mike Caulfield। তাঁর Four Moves কাঠামো ২০১৭ সাল থেকে শেখানো হচ্ছিল; ২০১৯ সালে চারটি ধাপ সহজে মনে রাখার জন্য SIFT নামটি ব্যবহার করা শুরু হয়।
অক্ষর চারটি হলো:
Stop — Investigate the source — Find better coverage — Trace the claim to its original context.
শব্দগুলো মুখস্থ করা জরুরি নয়। ভাবটা সহজ:
থামুন। কে বলছে দেখুন। অন্য ভালো উৎস খুঁজুন। তারপর সম্ভব হলে মূল জায়গায় ফিরে যান।
SIFT-এর সুবিধা হলো, এটি “এই ওয়েবসাইট ভালো” বা “ওই ওয়েবসাইট খারাপ”—এমন স্থায়ী রায় দেওয়ার চেষ্টা করে না। বরং যে নির্দিষ্ট দাবিটি আপনার সামনে এসেছে, সেটির পক্ষে যথেষ্ট ভিত্তি আছে কি না দেখতে শেখায়।
আরও পড়ুন: ডেটা লিটারেসি কী: চার্ট দেখে ভুল সিদ্ধান্ত এড়ানোর উপায়
কোনো পোস্ট দেখে প্রথমেই কী করবেন?
সঙ্গে সঙ্গে সার্চ শুরু করারও দরকার নেই। আগে ঠিক করুন, কোন কথাটি যাচাই করতে চান। ধরা যাক, একটি পোস্টে লেখা হলো, আগামী মাস থেকে কোনো সরকারি নিয়ম বদলে যাচ্ছে।
এখানে “পোস্টটি ভুয়া কি না” প্রশ্নটি খুব বড়। তার বদলে ছোট প্রশ্ন করুন:
কোন নিয়ম?
কোন প্রতিষ্ঠান ঘোষণা করেছে?
কবে থেকে কার্যকর হওয়ার কথা?
মূল নোটিশ কোথায়?
এই কয়েকটি প্রশ্ন বের করতে পারলেই যাচাই অনেক সহজ হয়ে যায়।
SIFT-এর Stop ধাপের আসল কাজ এটিই। আবেগের জায়গা থেকে একটু সরে এসে দাবিটিকে স্পষ্ট করা। বিশেষ করে যে পোস্ট আপনাকে খুব দ্রুত রাগিয়ে দেয়, ভয় দেখায় বা অবাক করে, সেখানে এই বিরতি আরও দরকার। কারণ তখনই মানুষ যাচাইয়ের আগে শেয়ার করে ফেলার ঝুঁকিতে থাকে।
সব তথ্য অবশ্য একইভাবে যাচাই করতে হবে না। কোনো সিনেমার মুক্তির তারিখ ভুল হলে ক্ষতি সীমিত। কিন্তু চিকিৎসা, চাকরি, অর্থ, পরীক্ষা কিংবা সরকারি নির্দেশনা নিয়ে ভুল তথ্যের প্রভাব আলাদা। ঝুঁকি বেশি হলে শুধু একটি পোস্ট বা দ্বিতীয় একটি ওয়েবসাইট দেখে থামা ঠিক হবে না।
উৎসটি দেখতে ভালো—এটাই কি যথেষ্ট?
না। অপরিচিত কোনো সাইটে ঢুকলে প্রথমেই আমরা তার চেহারা বিচার করি। লোগো আছে, লেখকের ছবি আছে, ভাষা পরিষ্কার, নিচে রেফারেন্সও দেওয়া—সব মিলিয়ে বেশ বিশ্বাসযোগ্য।
কিন্তু এসব এখন খুব সহজে তৈরি করা যায়।
এ কারণেই SIFT-এর Investigate the source ধাপটি গুরুত্বপূর্ণ। উৎসটি নিজের সম্পর্কে কী লিখেছে, শুধু তা পড়লে চলবে না। বাইরে গিয়ে দেখুন অন্য জায়গায় তাকে কীভাবে বর্ণনা করা হয়েছে।
ধরা যাক, একটি ওয়েবসাইট নিজেকে স্বাধীন গবেষণা প্রতিষ্ঠান বলছে। নতুন একটি ট্যাবে তার নাম সার্চ করুন। কারা এটি চালায়? কোনো বিশ্ববিদ্যালয়, সরকারি সংস্থা বা পরিচিত প্রতিষ্ঠানের সঙ্গে সম্পর্ক আছে? নাকি এটি মূলত বাণিজ্যিক প্রচারণার সাইট?
পেশাদার fact-checkerদের কাজ নিয়ে Stanford-এর গবেষণায় এই ধরনের আচরণ দেখা গেছে। তারা অপরিচিত ওয়েবসাইটের ভেতরে বসে সবকিছু বিচার করার বদলে অন্য ট্যাব খুলে সাইটটি সম্পর্কে তথ্য খুঁজেছেন। এই অভ্যাসটি lateral reading নামে পরিচিত।
বাংলায় সহজ করে বললে: একটি সাইটকে যাচাই করতে সেই সাইটের বাইরে যান।
এখানে অবশ্য আরেকটি ভুল করা যাবে না। কোনো উৎসের ব্যবসায়িক স্বার্থ আছে মানেই তার সব তথ্য মিথ্যা নয়। আবার পরিচিত প্রতিষ্ঠানের নাম থাকলেই প্রতিটি দাবি সঠিক হয় না। প্রশ্নটি সব সময় একই: এই নির্দিষ্ট দাবিটির পক্ষে কী প্রমাণ আছে?
সন্দেহজনক পেজ নিয়ে বেশি সময় কাটানোর দরকার নাও হতে পারে
এখানেই SIFT সাধারণ উৎস-যাচাইয়ের তালিকা থেকে একটু আলাদা। একটি অচেনা পেজে লেখা হয়েছে, কোনো বিশ্ববিদ্যালয়ের ভর্তি নীতি বদলে গেছে। আপনি চাইলে পেজটির মালিক কে, ডোমেইন কত পুরোনো, লেখকের পরিচয় কী—এসব খুঁজে আধা ঘণ্টা কাটাতে পারেন।
কিন্তু কাজটি আরও সরাসরি করা যায়। বিশ্ববিদ্যালয়ের নিজস্ব ওয়েবসাইটে যান। ভর্তি দপ্তরের নোটিশ দেখুন। প্রয়োজনে নির্ভরযোগ্য সংবাদমাধ্যমে একই পরিবর্তনের খবর আছে কি না খুঁজুন।
এটাই Find better coverage।
অর্থাৎ দুর্বল একটি উৎসকে প্রমাণ করার চেষ্টা না করে, একই বিষয়ে আরও শক্ত উৎস খুঁজুন।
গবেষণার দাবিতেও একই নিয়ম কাজে দেয়। সোশ্যাল মিডিয়া পোস্টে “নতুন গবেষণায় প্রমাণিত” লেখা থাকলে প্রথমেই সেই পোস্ট নিয়ে তর্ক করার দরকার নেই। গবেষণাটির নাম পাওয়া যায় কি না দেখুন। বিশ্ববিদ্যালয়, জার্নাল বা গবেষণা প্রতিষ্ঠানের মূল প্রকাশনা খুঁজুন।
তবে “অনেক জায়গায় একই খবর আছে” দেখেও নিশ্চিত হয়ে যাবেন না।
দশটি ওয়েবসাইট একই সংবাদ প্রকাশ করেছে—দেখতে দশটি আলাদা সমর্থন মনে হতে পারে। কিন্তু একটু খুলে দেখলে হয়তো দেখা যাবে সবাই একই সংবাদ সংস্থা বা একই প্রেস রিলিজ থেকে তথ্য নিয়েছে।
সংখ্যা নয়, উৎসগুলোর স্বাধীনতা এখানে বেশি গুরুত্বপূর্ণ।
উল্টো ঘটনাও ঘটে। স্থানীয় বা সদ্য ঘটে যাওয়া কোনো বিষয়ে দ্বিতীয় প্রতিবেদন পাওয়া যাচ্ছে না। সেখান থেকে সরাসরি “খবরটি মিথ্যা” সিদ্ধান্তে যাওয়া ঠিক নয়। তখন সবচেয়ে সৎ অবস্থান হতে পারে: এখনো নিশ্চিত হওয়ার মতো তথ্য নেই।
স্ক্রিনশট, ছবি বা উদ্ধৃতি পেলেই মূল জায়গাটি খুঁজুন
অনলাইন ভুল তথ্যের একটি বড় অংশ তৈরি হয় প্রেক্ষাপট সরিয়ে।
একটি ছবি সত্যি। কিন্তু সেটি অন্য দেশের।
একটি বক্তব্য সত্যিই দেওয়া হয়েছে। কিন্তু বাক্যটির আগে কী বলা হয়েছিল, সেটি বাদ গেছে। একটি গবেষণা সত্যি। কিন্তু গবেষকেরা “সম্পর্ক পাওয়া গেছে” বলেছেন, আর সোশ্যাল মিডিয়ার পোস্টে লেখা হয়েছে “কারণ প্রমাণিত”।
SIFT-এর Trace ধাপটি এই সমস্যা ধরতে সাহায্য করে।
উদ্ধৃতি দেখলে চেষ্টা করুন পুরো বক্তব্য খুঁজতে। ভিডিওর একটি কাটা অংশ সামনে এলে দীর্ঘ সংস্করণ আছে কি না দেখুন। কোনো গবেষণার দাবি হলে সম্ভব হলে মূল গবেষণাপত্র পর্যন্ত যান। ছবির ক্ষেত্রে Google Lens বা reverse image search আগের প্রকাশ খুঁজতে সহায়ক হতে পারে। তবে একই ছবি পুরোনো কোনো পেজে পাওয়া গেলেই যাচাই শেষ নয়। ছবিটি কখন, কোথায় এবং কী প্রসঙ্গে প্রকাশিত হয়েছিল, সেটিও মিলতে হবে।
স্ক্রিনশটের ক্ষেত্রেও সতর্ক থাকুন। স্ক্রিনশট একটি নথির ছোট অংশ দেখায়; সম্পূর্ণ পেজ নয়। মূল ওয়েবপেজ বা নথি পাওয়া গেলে সেটিই বেশি মূল্যবান।
একটি সাধারণ উদাহরণ
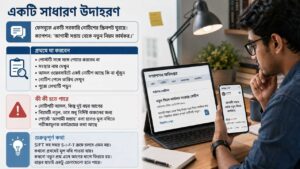
ধরা যাক, ফেসবুকে একটি সরকারি নোটিশের স্ক্রিনশট ঘুরছে। ক্যাপশনে লেখা, “আগামী সপ্তাহ থেকে নতুন নিয়ম কার্যকর।”
প্রথমেই পোস্টটি শেয়ার করার দরকার নেই।
স্ক্রিনশটে কোন সংস্থার নাম আছে দেখুন। সেই সংস্থার আসল ওয়েবসাইটে একই নোটিশ পাওয়া যায় কি না খুঁজুন। নোটিশটি পেলে তারিখ দেখুন। পুরো লেখাটি পড়ুন। হয়তো নোটিশটি আসল, কিন্তু দুই বছর আগের।
হয়তো নিয়মটি সত্যিই নতুন, তবে শুধু নির্দিষ্ট একটি অঞ্চলে প্রযোজ্য।
অথবা পোস্টে “আগামী সপ্তাহ” বলা হলেও মূল নথিতে পরীক্ষামূলক কার্যক্রমের কথা রয়েছে।
এখানে লক্ষণীয় বিষয় হলো, SIFT কোনো পরীক্ষার খাতার মতো S-I-F-T ক্রমে অনুসরণ করতেই হবে এমন নয়। কখনো প্রথমেই মূল নথি পাওয়া যায়। কখনো উৎসের পরিচয় যাচাই করতে গিয়ে নতুন প্রশ্ন আসে। তখন আগের ধাপে ফিরে যেতে হয়।
বাস্তব যাচাই এমনই একটু এলোমেলো।
শিক্ষার্থী, সাংবাদিক আর সাধারণ পাঠকের প্রয়োজন এক নয়
একজন শিক্ষার্থী অ্যাসাইনমেন্ট লিখছেন। তাঁর কাছে একটি ব্লগে দরকারি তথ্য পাওয়া গেল। ব্লগটি বিষয়টি বুঝতে সাহায্য করতে পারে, কিন্তু উদ্ধৃতির জন্য সেটিই যথেষ্ট কি না দেখতে হবে। লেখক কে, কোন গবেষণার ওপর তথ্য দাঁড়িয়ে আছে এবং মূল গবেষণাটি পাওয়া যায় কি না—এসব তখন বেশি গুরুত্বপূর্ণ।
গবেষকের সমস্যা আরও আলাদা। কোনো গবেষণা সত্যিই প্রকাশিত হয়েছে জানা আর গবেষণাটি ভালো কি না বিচার করা এক বিষয় নয়। গবেষণার পদ্ধতি, নমুনা, peer review, বিশ্লেষণ এবং সীমাবদ্ধতা দেখতে হয়। SIFT এখানে প্রথম ছাঁকনি হতে পারে, পূর্ণাঙ্গ গবেষণা মূল্যায়ন নয়।
সাংবাদিকের ক্ষেত্রে যাচাই আরও গভীরে যেতে পারে। অন্য একটি সংবাদমাধ্যম ভিডিওটি ব্যবহার করেছে—এটাই যথেষ্ট নয়। ভিডিও কোথায় ধারণ করা হয়েছে, কখন, প্রথম কে প্রকাশ করেছে—এসব প্রশ্নও গুরুত্বপূর্ণ হয়ে উঠতে পারে।
সাধারণ ব্যবহারকারীর জন্য এত দূর যাওয়ার প্রয়োজন সব সময় নেই। চাকরির বিজ্ঞাপন দেখলে কোম্পানির আসল careers page দেখা, পরীক্ষার সময়সূচি নিয়ে পোস্ট দেখলে প্রতিষ্ঠানের নোটিশ দেখা, ব্যাংকসংক্রান্ত বার্তা এলে ব্যাংকের নিজস্ব যোগাযোগমাধ্যম পরীক্ষা করা—এগুলোও একই ধরনের যাচাই।
কয়েকটি জায়গায় মানুষ বারবার ভুল করে
সবচেয়ে পরিচিত ভুল হলো Google-এ প্রথম ফলাফলকেই সবচেয়ে নির্ভরযোগ্য ধরে নেওয়া। সার্চে প্রথমে থাকা মানে সত্যের পরীক্ষায় প্রথম হওয়া নয়। আরেকটি হলো, একই খবর অনেক সাইটে দেখে নিশ্চিন্ত হয়ে যাওয়া। উৎসগুলো যদি একই জায়গা থেকে কপি করে থাকে, তাহলে পাঁচটি সাইট আসলে একটি উৎসই।
স্ক্রিনশট নিয়েও একই সমস্যা। লেখাটি সত্যিই কোনো ওয়েবসাইটে ছিল কি না, কখন ছিল, পুরো বক্তব্য কী ছিল—স্ক্রিনশট থেকে সব জানা যায় না।
এখন এআইয়ের উত্তরকেও অনেকে উৎস হিসেবে ব্যবহার করছেন। কোনো বিষয় দ্রুত বোঝা বা কী খুঁজতে হবে তা জানার জন্য generative AI সহায়ক হতে পারে। কিন্তু তার দেওয়া তথ্য বা citation সব সময় নির্ভুল নয়। NIST generative AI-এর আত্মবিশ্বাসের সঙ্গে ভুল বা বানানো তথ্য দেওয়ার ঝুঁকিকে confabulation বলে বর্ণনা করেছে।
তাই এআইয়ের উত্তর থেকে সূত্র পাওয়া যেতে পারে; কিন্তু গুরুত্বপূর্ণ দাবির ক্ষেত্রে সেই সূত্রটি সত্যিই আছে কি না এবং মূল উৎসে কী বলা হয়েছে, সেটি আলাদাভাবে দেখা দরকার।
Wikipedia ব্যবহার করবেন, নাকি করবেন না?
এই প্রশ্নের উত্তর “হ্যাঁ” বা “না” দিয়ে শেষ করা কঠিন।
অপরিচিত কোনো ব্যক্তি, প্রতিষ্ঠান বা প্রকাশনা সম্পর্কে দ্রুত ধারণা পেতে Wikipedia কাজে লাগতে পারে। SIFT শেখানোর কিছু উপকরণেও এভাবে Wikipedia ব্যবহারের উদাহরণ আছে।
কিন্তু এটি অনেক ক্ষেত্রে প্রথম ধাপ, শেষ ধাপ নয়।
ধরা যাক, কোনো প্রতিষ্ঠানের মালিকানা সম্পর্কে Wikipedia-তে তথ্য পেলেন। গুরুত্বপূর্ণ হলে পাশে দেওয়া রেফারেন্স খুলে মূল উৎসটি দেখা ভালো। অর্থাৎ Wikipedia আপনাকে দরজা পর্যন্ত নিয়ে যেতে পারে; ভেতরে ঢোকা বাকি থাকে।
SIFT কোথায় থামে
SIFT-এর সীমাবদ্ধতা বোঝাও জরুরি।
এটি দ্রুত উৎস যাচাইয়ের পদ্ধতি। চিকিৎসাবিষয়ক গবেষণা বিশ্লেষণ, আইনের ব্যাখ্যা, বিনিয়োগের ঝুঁকি নির্ধারণ বা কারও বিরুদ্ধে গুরুতর অভিযোগ যাচাইয়ের পূর্ণাঙ্গ ব্যবস্থা নয়।
এসব ক্ষেত্রে মূল নথি, সংশ্লিষ্ট কর্তৃপক্ষ, একাধিক স্বাধীন উৎস এবং কখনো বিষয়বিশেষজ্ঞের মতামত দরকার হতে পারে। আর কোনো পরিচিত সংবাদমাধ্যম বা প্রতিষ্ঠান সাধারণত নির্ভরযোগ্য বলেই তার একটি নির্দিষ্ট প্রতিবেদন যাচাইয়ের ঊর্ধ্বে চলে যায় না। মানুষ ও প্রতিষ্ঠান—দুটিই ভুল করতে পারে।
একইভাবে অচেনা উৎস মানেই ভুয়া নয়। কোনো ঘটনার প্রথম ছবি হয়তো সাধারণ একজন প্রত্যক্ষদর্শীই পোস্ট করেছেন। তখন উৎসের পরিচিতির পাশাপাশি ছবিটির সময়, স্থান এবং অন্য প্রমাণ দেখতে হবে।
সব সময় উত্তর পাওয়া যাবে না
অনলাইনে তথ্য যাচাই করতে গিয়ে একটি অস্বস্তিকর জায়গা আসে: অনেক সময় যথেষ্ট প্রমাণ পাওয়া যায় না।
সেখানে অনুমান দিয়ে ফাঁক পূরণ করার দরকার নেই।
“সত্য” এবং “মিথ্যা”-র মাঝখানে “এখনো যাচাই করা যায়নি” নামে একটি বৈধ অবস্থান আছে।
SIFT source evaluation-এর সবচেয়ে ব্যবহারিক শিক্ষা সম্ভবত এখানেই। একটি পোস্ট দেখে সঙ্গে সঙ্গে পক্ষ নেওয়ার দরকার নেই। কে বলছে, অন্য ভালো উৎস কী বলছে এবং মূল প্রেক্ষাপট কোথায়—এই তিনটি জায়গায় একটু খোঁজ করলেই অনেক দুর্বল দাবি ধরা পড়ে।
প্রায়শই জিজ্ঞাসিত প্রশ্ন
SIFT ব্যবহার করে একটি তথ্য যাচাই করতে কত সময় লাগে?
নির্দিষ্ট সময় নেই। সহজ কোনো দাবি কয়েক মিনিটেই যাচাই করা যেতে পারে, বিশেষ করে মূল নথি বা নির্ভরযোগ্য উৎস সহজে পাওয়া গেলে। নতুন, স্থানীয় বা জটিল বিষয়ে বেশি সময় লাগতে পারে। SIFT-এর উদ্দেশ্য প্রতিটি তথ্য নিয়ে দীর্ঘ তদন্ত করা নয়; বরং কোথায় আরও যাচাই দরকার তা দ্রুত বোঝা।
সোশ্যাল মিডিয়ার ছবি ও ভিডিও যাচাইয়েও কি SIFT ব্যবহার করা যায়?
হ্যাঁ। ছবি বা ভিডিওর ক্ষেত্রে বিশেষ করে Trace ধাপটি কাজে লাগে। মূল আপলোড, আগের প্রকাশ, তারিখ, স্থান এবং সম্পূর্ণ ভিডিও পাওয়া যায় কি না খুঁজে দেখা যায়। Google Lens বা reverse image search অনুসন্ধানে সহায়তা করতে পারে, তবে একটি মিল পাওয়া গেলেই সত্যতা নিশ্চিত হয়ে যায় না।
একই খবর কয়েকটি পরিচিত ওয়েবসাইটে থাকলে কি সেটি সত্য ধরে নেওয়া যায়?
না। কয়েকটি ওয়েবসাইট একই মূল সংবাদ, প্রেস রিলিজ বা সোশ্যাল পোস্ট থেকে তথ্য নিতে পারে। তাই কতটি সাইট খবরটি প্রকাশ করেছে তার পাশাপাশি তারা স্বাধীনভাবে তথ্যটি নিশ্চিত করেছে কি না দেখাও জরুরি।
SIFT ব্যবহার করার পরও নিশ্চিত হতে না পারলে কী করবেন?
তথ্যটিকে জোর করে সত্য বা মিথ্যা হিসেবে চিহ্নিত করার প্রয়োজন নেই। যথেষ্ট প্রমাণ না থাকলে ‘এখনো যাচাই করা যায়নি’ অবস্থান রাখা বেশি যুক্তিসঙ্গত। বিশেষ করে তথ্যটি অন্যদের কাছে শেয়ার করার আগে অপেক্ষা করা ভালো।
SIFT কি চিকিৎসা, আইন বা আর্থিক তথ্য যাচাইয়ের জন্য যথেষ্ট?
প্রাথমিক যাচাইয়ের জন্য কাজে লাগতে পারে, কিন্তু এসব উচ্চ-ঝুঁকির বিষয়ে SIFT একা যথেষ্ট নয়। মূল নথি, সংশ্লিষ্ট কর্তৃপক্ষ, নির্ভরযোগ্য স্বাধীন উৎস এবং প্রয়োজন হলে বিষয়বিশেষজ্ঞের মতামতও দেখা দরকার।