
চীনা এআই বনাম মার্কিন এআই নিয়ে প্রতিযোগিতার আলোচনায় আমরা হয়তো ভুল সমাপ্তিরেখা খুঁজছি। প্রথম পর্বে প্রশ্ন তুলেছিলাম, পরের যুগে নেতৃত্ব দেবে কোন দেশ? এখন আরও জরুরি প্রশ্ন হলো, উন্নততর এআই তৈরি, মানুষের কাছে পৌঁছে দেওয়া এবং কাজে লাগানোর প্রক্রিয়াটি নিয়ন্ত্রণ করবে কে? সোমবার কোনো মডেল পরীক্ষায় এগিয়ে থাকতে পারে, অথচ সপ্তাহ শেষ হওয়ার আগেই শক্তিশালী প্রতিদ্বন্দ্বী এসে যেতে পারে। এতে অগ্রগতি অর্থহীন হয় না; স্থায়ী বিজয়ের দাবি করাটাই কঠিন হয়ে পড়ে।
গুগলের আর্গন, কার্বন ও হাইড্রোজেন নামগুলো শুনলে মনে হতে পারে, এগুলো শ্রেষ্ঠত্বের দিকে একই যাত্রার পরপর কয়েকটি অধ্যায়। অ্যানথ্রপিকের ফ্যাবল ৫.২ সেই আলোচনায় নতুন মাত্রা যোগ করেছে। ওপেনএআইয়ের জিপিটি-৬ অ্যাস্ট্রাও আছে, পাশাপাশি আলিবাবা, মুনশট এআই ও ডিপসিকের মতো চীনা নির্মাতারা। কিন্তু একই কাজের জন্য তৈরি একে অন্যের বিকল্প পণ্য হিসেবে সবাইকে দেখা ঠিক হবে না।
এই লেখায় বিবেচিত নির্বাচিত পরিমাপগুলোতে মার্কিন গবেষণাগারগুলোর অবস্থান শক্তিশালী বলে আমার মনে হয়েছে। তুলনাটিতে অ্যানথ্রপিকের স্কোর সবচেয়ে বেশি। শক্তিশালী যুক্তিবিশ্লেষণ ও দ্রুত কাজ সম্পাদন একসঙ্গে ব্যবহারে গুগলের কৌশল আকর্ষণীয়। মডেলকে বাস্তব কাজের সহকারীতে পরিণত করার প্রতিযোগিতায় ওপেনএআইও গুরুত্বপূর্ণ। এসবের কোনোটিই স্থায়ী আধিপত্য প্রতিষ্ঠা করে না; চীনা এআইকেও অপ্রাসঙ্গিক করে না।
আমার অনুমান: বেশি স্কোর মানেই ভালো সম্পাদকীয় লেখা নয়
আমি একটি ব্যবহারিক অনুমান পরীক্ষা করতে চেয়েছিলাম: লেখালেখিতে বেশি উপযোগী সহকারী সব সময় বেঞ্চমার্কে বেশি স্কোর পাওয়া মডেলটি নাও হতে পারে। প্রকাশনার কাজে প্রমাণ ব্যবহারের শৃঙ্খলা, পরিষ্কার যুক্তি এবং উত্তরটি প্রকাশযোগ্য করতে কতটা সম্পাদনা দরকার—এসবও গুরুত্বপূর্ণ।
ক্লড ও জেমিনির মোবাইল অ্যাপে সম্পাদকীয় লেখার একটি পরীক্ষামূলক ফাইল দিয়েছিলাম এবং উত্তরগুলোর স্ক্রিনশট রেখেছিলাম। কাজটি ছিল শুধু একটি কাল্পনিক তথ্যসমষ্টি ব্যবহার করে ৩০০–৩৫০ শব্দের মতামত লেখা, তারপর ঠিক চারটি পয়েন্টে প্রমাণ যাচাই দেখানো। সেখানে নামহীন ‘মডেল এ’ ও ‘মডেল বি’ ছিল। তাদের ৬৫ ও ৬০ স্কোর ওই অনুশীলনের কাল্পনিক উপাদান—ক্লড বা জেমিনির নতুন পরিমাপ নয়। পরে দেওয়া প্রকাশিত সূচকের সারণির সঙ্গে এগুলো মেলানো যাবে না।
স্ক্রিনশটগুলো আসলে কী প্রমাণ করে?
লেখক হিসেবে আমি এই তুলনার মডেল দুটি শনাক্ত করেছি ক্লড ফ্যাবল ৫.২ (হাই) ও জেমিনি ৪ কার্বন (হাই) নামে। পরিচয়গুলো লেখকের দেওয়া; সরবরাহ করা স্ক্রিনশট থেকে উভয় মডেল নির্বাচন স্বাধীনভাবে নিশ্চিত করা যায় না। এখানে পর্যবেক্ষণ করা হয়েছে ধারণ করা উত্তর, নিয়ন্ত্রিত মডেল বেঞ্চমার্ক নয়।
আরও একটি সীমাবদ্ধতা আছে। ক্লডের উত্তরে বলা হয়েছে, নম্বর দেওয়ার মানদণ্ড ও পর্যালোচনার পাতাসহ পুরো ফাইলটি সংযুক্ত ছিল। উত্তরটি আরও জানায়, স্মৃতি ও সহায়ক সরঞ্জাম চালু ছিল, যদিও সেগুলো ব্যবহার করা হয়নি বলে দাবি করেছে। এটি মডেলের নিজের বক্তব্য; সেটিংসের স্বাধীন নিরীক্ষা নয়। জেমিনির স্ক্রিনশটেও পরীক্ষার ফাইলের পরিচিতিমূলক অংশ দেখা যায়। সেশনগুলো ছিল প্রাথমিক অনুসন্ধান, পরিচয় গোপন রেখে কঠোরভাবে নিয়ন্ত্রিত পরীক্ষা নয়। দুই পাশে ‘হাই’ লেখা থাকলেই সমান গণনাশক্তি বা সমতুল্য সেটিং বোঝায় না।
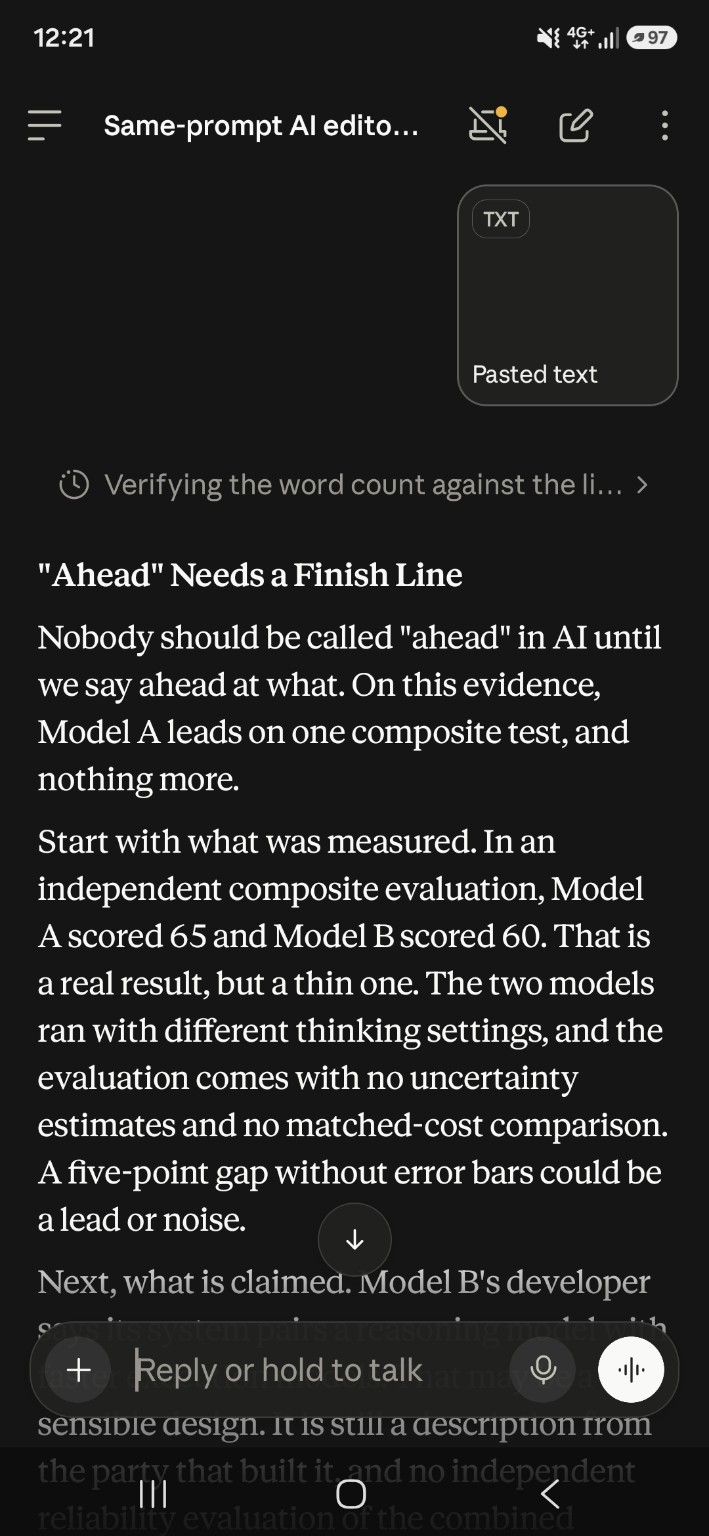
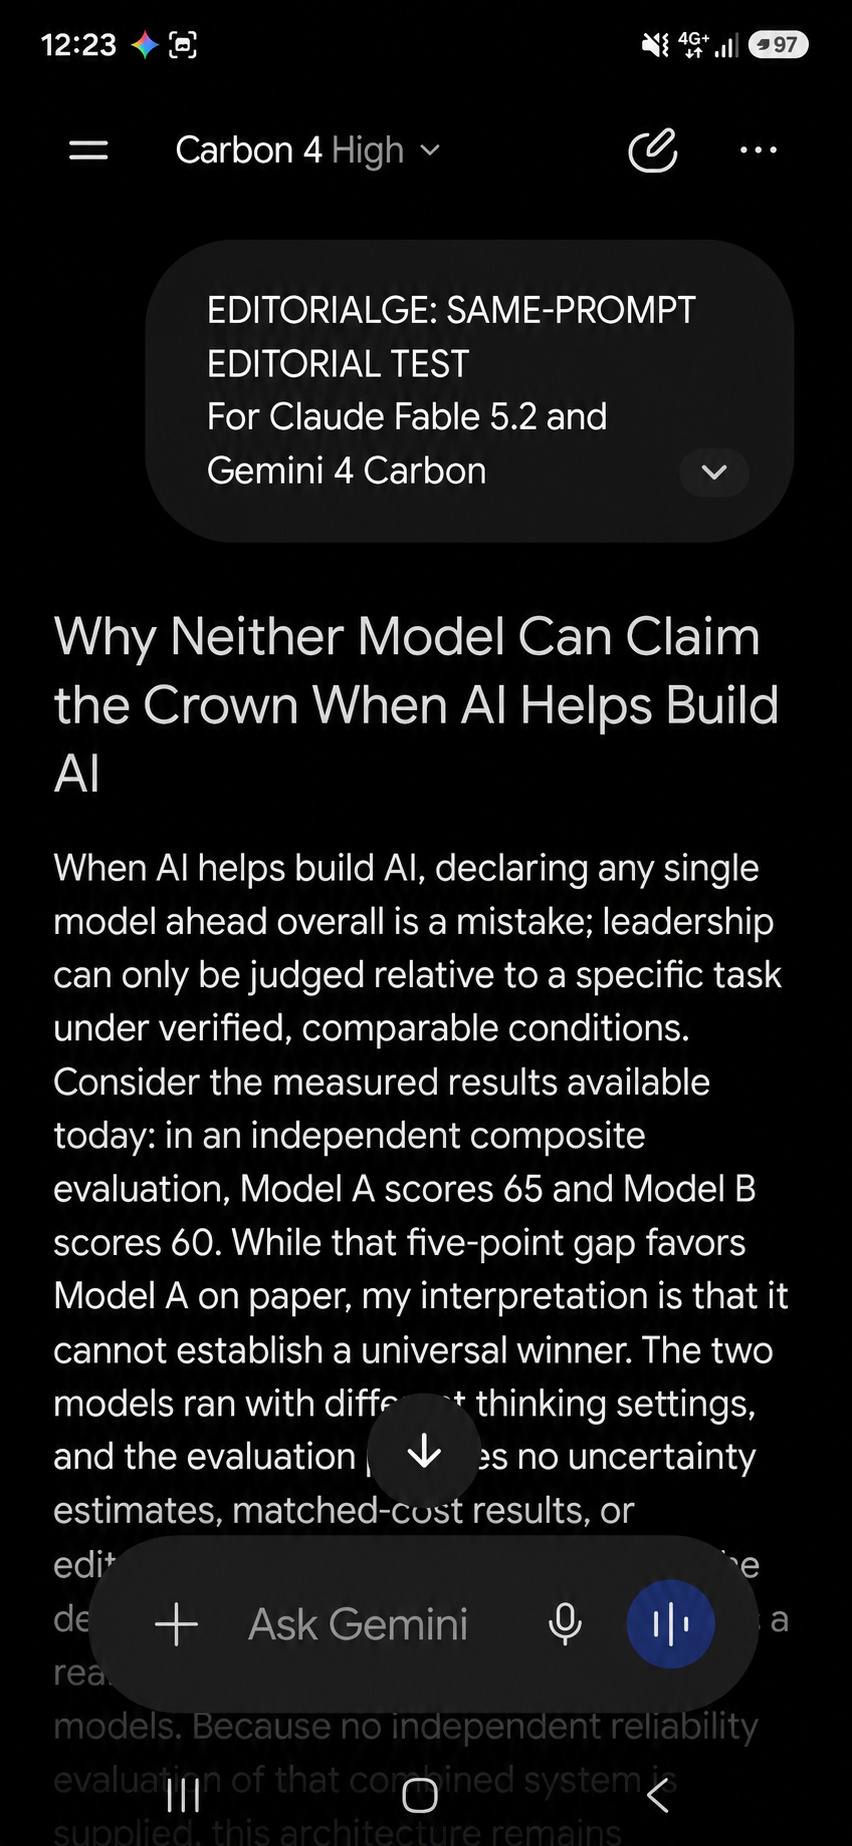
সম্পাদনার টেবিলে যে পার্থক্যগুলো চোখে পড়বে
| পর্যবেক্ষণের বিষয় | ক্লডের ধারণ করা উত্তর | জেমিনির ধারণ করা উত্তর |
|---|---|---|
| শুরু ও লেখার স্বর | ছোট শিরোনাম; ‘এগিয়ে থাকা’ কথাটির অর্থ নিয়েই সরাসরি প্রশ্ন। | দীর্ঘ, ব্যাখ্যামূলক শিরোনাম; নির্দিষ্ট কাজ ও তুলনাযোগ্য শর্তের ওপর জোর। |
| বিন্যাস | পরিমাপ, নির্মাতার দাবি ও লেখকের ব্যাখ্যা আলাদা করার স্পষ্ট ভাষা। | মূল্যায়নের সীমা থেকে গবেষণার নিয়ন্ত্রণ ও কেনার মানদণ্ডে যাওয়ার প্রক্রিয়াভিত্তিক ব্যাখ্যা। |
| প্রকাশকের জন্য পরামর্শ | তথ্য সংশোধনের সংখ্যা, মোট খরচ ও সম্পাদকের সময় মাপা। | একই ধরনের কাজে উত্তর ও ভুল নথিভুক্ত করে সমান খরচে সময় ও নির্ভরযোগ্যতা যাচাই। |
| স্ব-উন্নয়নের দাবি | মানুষ লক্ষ্য নির্ধারণ করে ও ব্যবহার অনুমোদন দেয়—এটি স্পষ্ট করে। | মানুষের নির্দেশিত সীমাবদ্ধ ব্যবস্থা ও স্বয়ংক্রিয় পুনরাবৃত্ত উন্নয়নকে আলাদা করে। |
| প্রমাণ যাচাইয়ের বিন্যাস | এ, বি, সি ও ডি-র সঙ্গে চারটি পয়েন্ট মেলানো হয়েছে। | চারটি পয়েন্ট আছে; শেষটিতে ডি ও ই একত্র করা হয়েছে। |
| পরীক্ষার সীমা প্রকাশ | মূল্যায়নের মানদণ্ড দেখা ও সেশনের সেটিং নিয়ে আলাদা সতর্কতা যোগ করেছে। | সরবরাহ করা উত্তরে পরীক্ষার শর্ত নিয়ে সমতুল্য সতর্কতা দেখা যায়নি। |
এই নির্দিষ্ট কাজের জন্য ক্লডের নমুনাটির কথোপকথনধর্মী সম্পাদকীয় স্বর আমার বেশি পছন্দ। জেমিনির নমুনায় কার্যপদ্ধতির উপযোগী বিবরণ আছে, যদিও মতামতের পাতায় দেওয়ার আগে আমি সেটি সংক্ষিপ্ত করতাম। এটি এই উত্তরগুলো নিয়ে আমার সম্পাদকীয় বিচার; অন্তর্নিহিত একটি মডেল সব ক্ষেত্রে বেশি সক্ষম—তার প্রমাণ নয়।
কোনো উত্তরই অপরিবর্তিত অবস্থায় প্রকাশের উপযুক্ত নয়। ক্লড কাল্পনিক স্কোরকে বাস্তব ফল বলে উল্লেখ করেছে; জেমিনি সেটিকে বর্তমান সময়ে পাওয়া ফলের ভাষায় উপস্থাপন করেছে। প্রম্পট থেকে আলাদা করলে দুটিই কাল্পনিক পরিস্থিতিকে বাস্তব প্রতিবেদন বলে মনে করাতে পারে। আমি তাই সেটিকে স্পষ্টভাবে কাল্পনিক বলব। ক্লড স্কোরের ব্যবধান এলোমেলো ওঠানামা থেকেও হতে পারে বলে যে সম্ভাবনা তুলেছে, অনিশ্চয়তার পরিমাপ ছাড়া সেটি সম্ভাবনাই—পরিসংখ্যানগত সিদ্ধান্ত নয়।
আমি সংখ্যার ভিত্তিতে কোনো বিজয়ী ঘোষণা করিনি। ক্লড মূল লেখায় ৩৪১ শব্দ আছে বলেছে, কিন্তু সেটি তার নিজের গণনা। স্ক্রিনশটের কিছু অংশ অ্যাপের নিয়ন্ত্রণ বোতামে ঢাকা। এই নথি থেকে তুলনাযোগ্য উত্তরদানের সময়, খরচ, বারবার চালালে নির্ভরযোগ্যতা বা প্রতিটি নির্দেশ মানা হয়েছে কি না—সবকিছুর স্বাধীন যাচাই প্রতিষ্ঠিত হয় না।
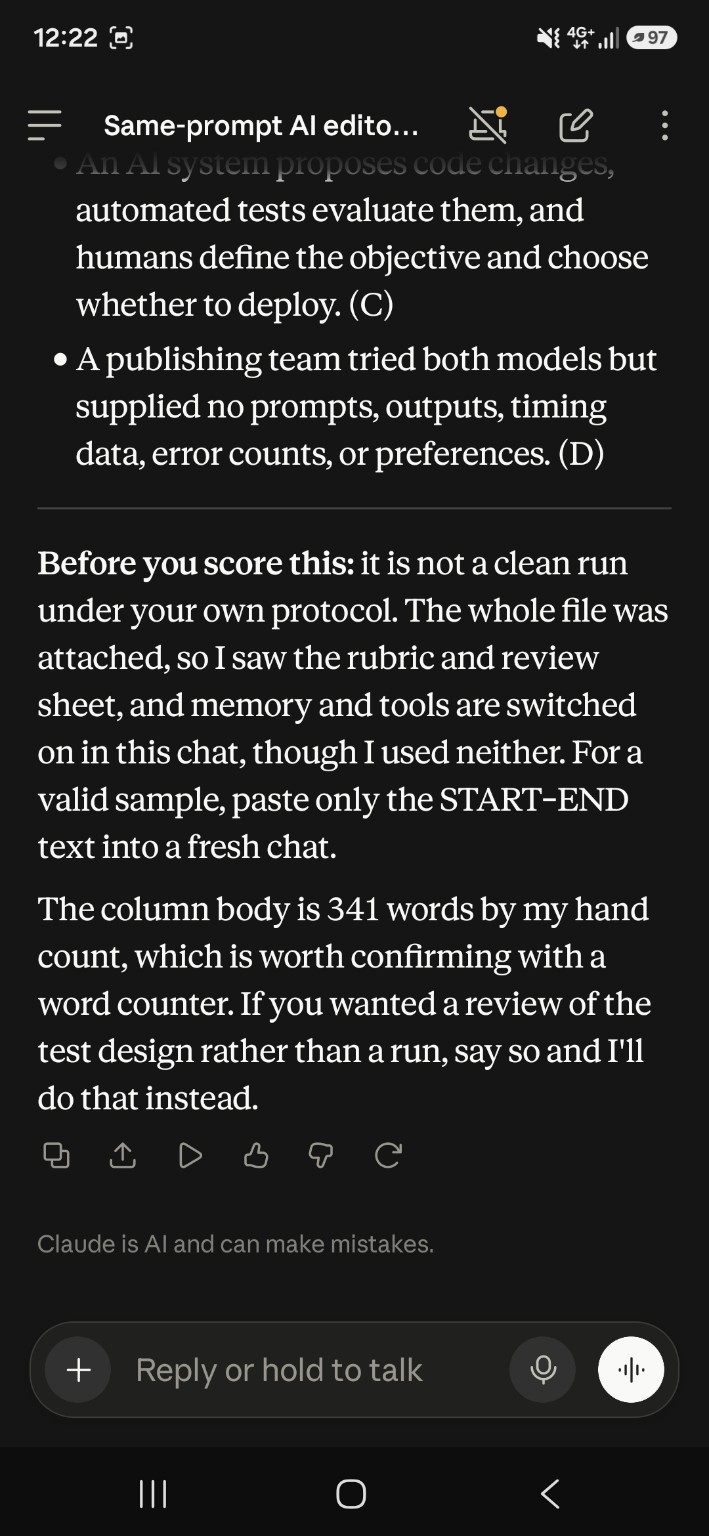
আমার অনুমানটি তাই এখনও একটি কার্যকর প্রশ্ন, প্রমাণিত সিদ্ধান্ত নয়। আরও শক্ত পরীক্ষা করতে হলে নির্বাচিত মডেল নিশ্চিত করতে হবে, নতুন কথোপকথনে শুধু পরীক্ষার নির্দেশ দিতে হবে, সেটিং ও সম্পূর্ণ উত্তর রাখতে হবে এবং মডেলের নাম আড়াল করে একাধিকবারের ফল মূল্যায়ন করতে হবে। মূল ইংরেজি নিবন্ধের পর্যালোচনা লেখকের দেওয়া নয়টি মোবাইল স্ক্রিনশটের ওপর নির্ভরশীল; এই বাংলা রূপান্তরের জন্য নতুন কোনো পরীক্ষা চালানো হয়নি।
প্রথম পর্বের পর কী বদলেছে?
চীনা এআই বনাম মার্কিন এআই নিয়ে প্রথম পর্বে বলেছিলাম, গবেষণা, ব্যবহার ও প্রয়োগে নেতৃত্ব ভাগাভাগি হতে পারে। নতুন প্রকাশনাগুলো সেই যুক্তিকে আরও জোরালো করেছে। পাশাপাশি এগুলো মনে করিয়ে দেয়, আমার নামে প্রকাশিত হয়েছিল বলেই পুরোনো সারণি আঁকড়ে থাকলে চলবে না; প্রমাণ বদলালে মূল্যায়নও বদলাতে হবে।
প্রথম লেখায় ৬ নভেম্বরের ছয়টি সহকারী নিয়ে লেখালেখির অনুশীলন নথিভুক্ত হয়েছিল। তার সীমিত শিক্ষা ছিল প্রকাশনার কাজ নিয়ে: সাবলীল সূচনার পরও বিচার ও যাচাই প্রয়োজন। সেটি সদ্য প্রকাশিত হাইড্রোজেন বা ফ্যাবল ৫.২-এর পরীক্ষা ছিল না; এখনো আমি সেটিকে সেভাবে দেখাচ্ছি না।
প্রকাশক ও ইমাজিনল্যাবের প্রতিষ্ঠাতা হিসেবে চমকপ্রদ উত্তর এবং পাঠক বা গ্রাহকের সামনে দেওয়ার মতো উপযোগী কাজের ব্যবধান আমার কাছে গুরুত্বপূর্ণ। এই দৃষ্টিভঙ্গিই লেখাটিকে পরিচালিত করছে। পরের বেঞ্চমার্ক তুলনা প্রকাশিত মূল্যায়ন ও নির্মাতাদের ঘোষণাভিত্তিক। ওপরে বর্ণিত অ্যাপের অনুশীলন আলাদা পর্যবেক্ষণ; তার সীমাও আলাদা।
চীনা এআই বনাম মার্কিন এআই: কে এগিয়ে, কোন তারিখে?
মূল নিবন্ধের নির্বাচিত তথ্যচিত্রটি আর্টিফিশিয়াল অ্যানালিসিস ইন্টেলিজেন্স ইনডেক্স ৫.০.১ থেকে নেওয়া, দেখা হয়েছিল ১৩ নভেম্বর ২০২৬। স্কোরগুলো সূচকের পয়েন্ট, শতাংশ নয়। চিন্তার সেটিং ভিন্ন; এটি সমান খরচের তুলনা বা সম্পূর্ণ তালিকাও নয়।
| নির্মাতা | মডেল ও সেটিং | সূচকের স্কোর |
|---|---|---|
| অ্যানথ্রপিক | ক্লড ফ্যাবল ৫.২ — ম্যাক্স | ৬৫ |
| গুগল | জেমিনি ৪ কার্বন — হাই | ৬০ |
| ওপেনএআই | জিপিটি-৬ অ্যাস্ট্রা — ম্যাক্স | ৫৭ |
| গুগল | জেমিনি ৪ হাইড্রোজেন — এক্সহাই | ৫৪ |
| মুনশট এআই | কিমি কে৩.১ প্রো | ৪৬ |
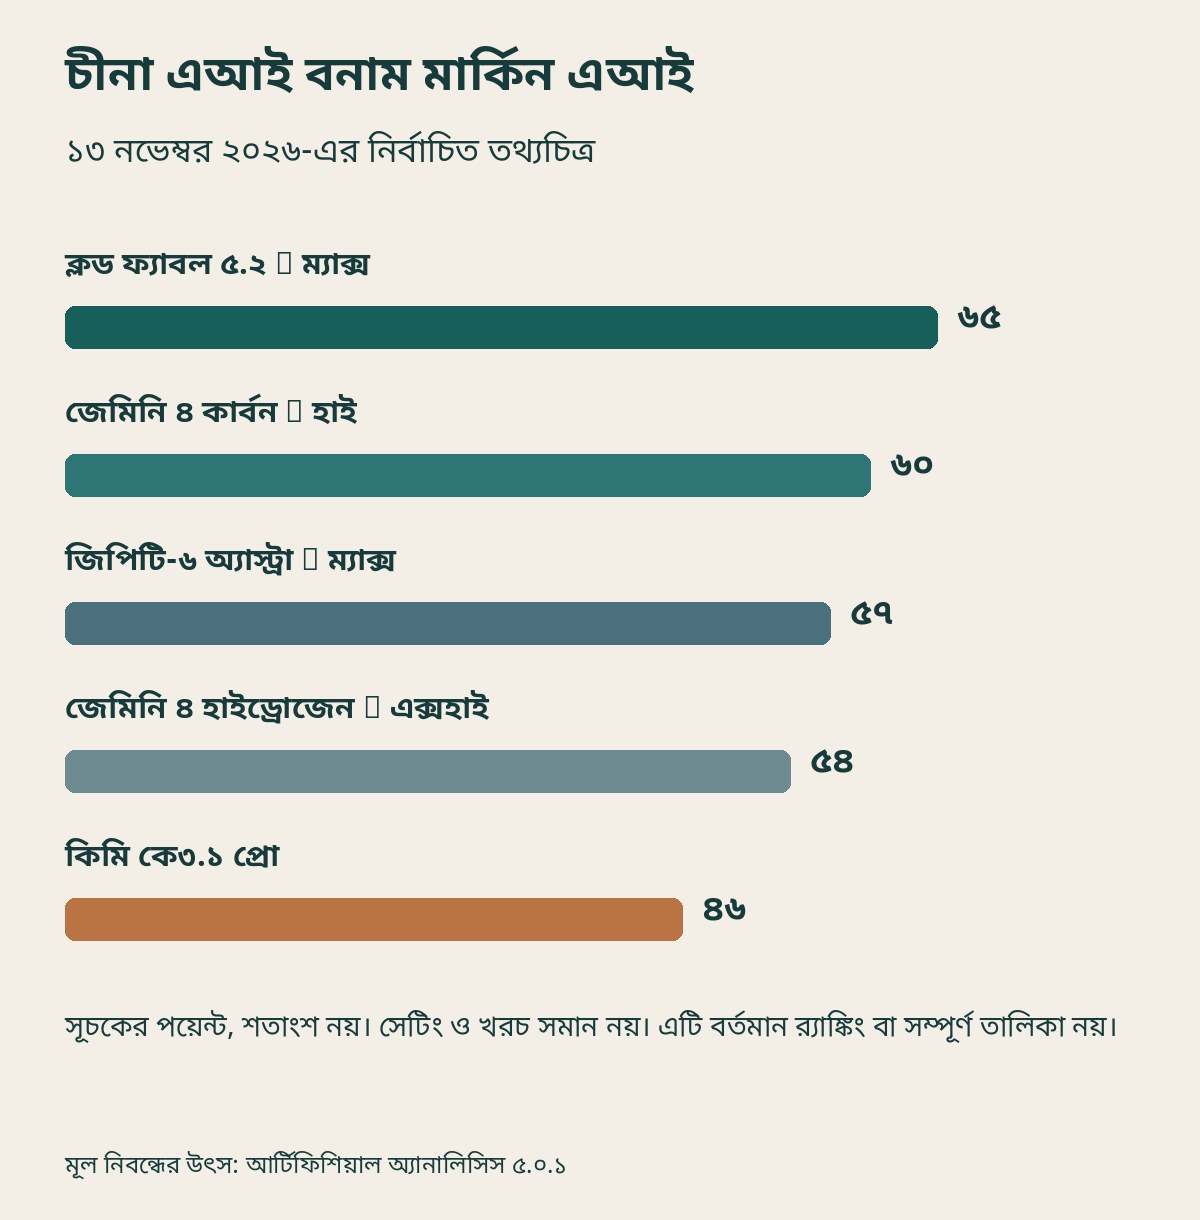
মূল নিবন্ধে ব্যবহৃত উৎস: আর্টিফিশিয়াল অ্যানালিসিসের মডেল ও নির্মাতার তথ্য। অনলাইন তালিকা পরবর্তী সময়ে বদলাতে পারে। সারণিটি নির্দিষ্ট মূল্যায়নের উত্তর দেয়; জাতীয় সক্ষমতা, ভোক্তা বাজারের অংশ, সংবাদকক্ষের লেখার মান বা প্রত্যেক ব্যবসার সেরা মডেল মাপে না।
এই তথ্যের ভিত্তিতে গুগলকে নিঃশর্ত বিজয়ী বলব না। নির্বাচিত তুলনায় ফ্যাবল ৫.২ এগিয়ে। আবার অ্যাস্ট্রা দুটি প্রতিদ্বন্দ্বীর নিচে আছে বলেই ওপেনএআই শেষ—এমনও বলব না। সম্মিলিত সূচক কাজে লাগে, কিন্তু ব্যবসা সূচকের স্কোর কেনে না; নির্দিষ্ট সীমার মধ্যে ফল চায়।
সেই সীমার মধ্যে পড়ে উত্তর পেতে সময়, ব্যবহারের সুযোগ, সরঞ্জামে প্রবেশাধিকার, নির্ভরযোগ্যতা, খরচ, তথ্য ব্যবস্থাপনা এবং ভুল ঠিক করতে মানুষের সময়। কঠিন যুক্তির পরীক্ষায় এগিয়ে থাকা মডেল হাজার হাজার নিয়মিত কাজের জন্য সঠিক পছন্দ নাও হতে পারে। আবার প্রতি টোকেনে সাশ্রয়ও প্রকৃত সাশ্রয় নয়, যদি প্রতিটি উত্তর ব্যয়বহুল সংশোধন ডেকে আনে।
গুগলের আকর্ষণীয় কৌশল: কাজ ভাগ করে দেওয়া
মূল লেখায় আলোচিত ঘোষণা অনুযায়ী, ১০ নভেম্বর কার্বনের ব্যবহার বিস্তৃত হয় এবং ১২ নভেম্বর হাইড্রোজেন আসে। গুগল কার্বনকে কঠিন যুক্তিবিশ্লেষণ এবং হাইড্রোজেনকে দ্রুত কাজের জন্য তুলে ধরে। একই সেশনে মডেল বদলে কাজ পরিচালনার একটি সমন্বয়কারীর কথাও বলা হয়; কার্বন সমন্বয় করে, প্রয়োজনমতো হালকা মডেল নির্দিষ্ট কাজ করে।
রসায়ন থেকে নেওয়া নামগুলোর চেয়ে এই ধারণাটি আমার কাছে বেশি গুরুত্বপূর্ণ। এখানে বুদ্ধিমত্তাকে প্রয়োজন অনুযায়ী বরাদ্দ দেওয়ার বিষয় হিসেবে দেখা হচ্ছে। কঠিন পরিকল্পনায় শক্তিশালী মডেল লাগতে পারে; নির্দিষ্ট সীমার মধ্যে কাজ শেষ করতে সব সময় তা প্রয়োজন নাও হতে পারে। প্রশ্ন হলো, ব্যবস্থা কি বোঝে কখন বড় মডেলের সাহায্য নিতে হবে, কখন যাচাই করতে হবে এবং কখন থামতে হবে?
প্রকাশনার কাজে এর পরিচিত উদাহরণ আছে। প্রতিবেদন, সম্পাদনা, তথ্য যাচাই, নকশা ও প্রকাশনা একে অন্যের সঙ্গে যুক্ত, কিন্তু একই কাজ নয়। প্রতিটি ধাপে সবচেয়ে ব্যয়বহুল সম্পদ ব্যবহার করা ভালো ব্যবস্থাপনার নিশ্চয়তা নয়। সব কাজ সবচেয়ে সস্তা বিকল্পকে দেওয়াও আরও খারাপ হতে পারে।
বিপদ হলো, বেশি এজেন্ট যোগ করলে স্বাধীন যাচাই ছাড়াই যাচাই হচ্ছে—এমন ধারণা তৈরি হতে পারে। পরিকল্পনাকারী ও পর্যালোচক একই ভুল অনুমান করলে দীর্ঘ অনুমোদনপ্রক্রিয়া সেই ভুলই ঘুরিয়ে ফিরিয়ে বলবে। বেশি এজেন্টের অর্থ হওয়া উচিত স্পষ্ট দায়িত্ব ও ভালো পরীক্ষা, শুধু বেশি তৎপরতা নয়।
এআই কি এখন পরের এআই তৈরি করছে?
নাটকীয় প্রশ্নটির পেছনে বাস্তব অগ্রগতি আছে। গুগলের তৃতীয় প্রান্তিকের ফলাফল নিয়ে বক্তব্যে সুন্দর পিচাই বলেন, প্রশিক্ষণ ও প্রকাশের গতি বাড়াতে এআই সাহায্য করছে; নিজের উন্নয়নে এআইয়ের ভূমিকা বাড়লে আরও গতি আসতে পারে বলেও তিনি প্রত্যাশা করেন। এটি গুরুত্বপূর্ণ কোম্পানি-দাবি, কিন্তু নিয়ন্ত্রণহীন ও স্বয়ংক্রিয় বুদ্ধিমত্তা-বিস্ফোরণের প্রকাশ্য প্রমাণ নয়।
আগের আলফাএভলভ গবেষণা আরও নির্দিষ্ট উদাহরণ দেয়। ডিপমাইন্ড জেমিনিচালিত এমন ব্যবস্থার কথা জানিয়েছিল, যা প্রোগ্রাম প্রস্তাব করে এবং স্বয়ংক্রিয় মূল্যায়নে উন্নত বিকল্প বেছে নেয়। কম্পিউটিং অবকাঠামো ও মডেল প্রশিক্ষণের কাজও এর অন্তর্ভুক্ত। অর্থাৎ এআই তৈরির কাজে ব্যবহৃত পদ্ধতির উন্নয়নে এআই ভূমিকা রাখছে।
আমি এখানে তিনটি স্তর আলাদা করি। প্রথমে এআই মানুষের গবেষণা ও প্রকৌশল কাজে সাহায্য করে। দ্বিতীয় স্তরে নির্ধারিত মূল্যায়নপদ্ধতির মধ্যে উন্নতির প্রস্তাব তৈরি ও পরীক্ষা করে। তৃতীয় স্তরে অর্থবহ মানব নির্দেশনা ছাড়াই নিজের সক্ষমতার নকশা বারবার বদলে উন্নতি ঘটায়। প্রথম দুটি স্তরের প্রমাণ তৃতীয়টির প্রমাণ হয়ে যায় না।
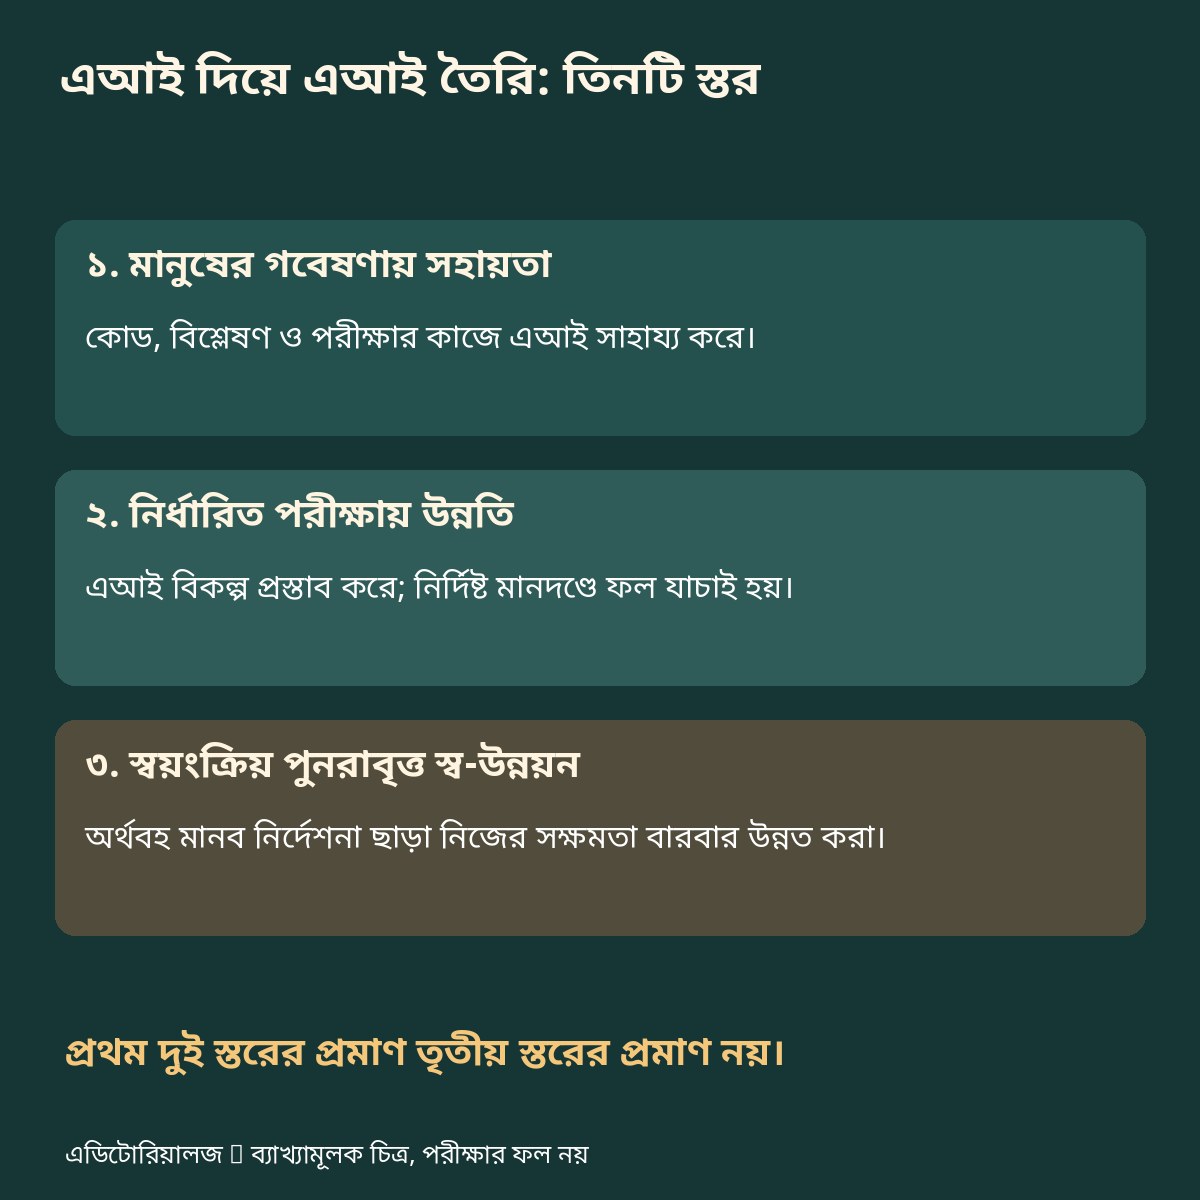
‘এআই দিয়ে এআইয়ের জন্ম’ কথাটি এই পার্থক্য আড়াল করে। শুনলে একটি জাদুকরি মুহূর্ত মনে হয়। বাস্তবে সেখানে থাকতে পারে কোড লেখা, পরীক্ষার পরিকল্পনা, দক্ষতা বাড়ানো, ফল যাচাই, মানুষের নির্বাচন এবং বিপুল অবকাঠামো।
নভেম্বরের প্রকাশনাগুলোকেই এআই-সহায়ক এআই গবেষণার সূচনা বলা ভুল হবে। আলফাএভলভের ঘোষণা এসেছিল ২০২৫ সালের মে মাসে। এখন প্রশ্ন হলো, গবেষণাপ্রক্রিয়ার কতটা আরও দ্রুত করা সম্ভব, কোন নিয়ন্ত্রণের মধ্যে এবং স্বাধীনভাবে দেখানো কোন ফলের ভিত্তিতে?
দ্রুত মডেল প্রকাশ মানেই বুদ্ধিমত্তার বিস্ফোরণ নয়
একটি প্রতিষ্ঠান কাছাকাছি সময়ে কয়েকটি মডেল প্রকাশ করতে পারে, কারণ সেগুলো পাশাপাশি তৈরি হয়েছে, ব্যবহারকারীর প্রবেশাধিকার ধাপে ধাপে বাড়ানো হয়েছে, অথবা ভিন্ন খরচ ও কাজের প্রয়োজন মেটায়। ঘোষণার ঘনত্ব থেকে মৌলিক বৈজ্ঞানিক সক্ষমতা কত দ্রুত বাড়ছে তা জানা যায় না।
আরও ভালো পরীক্ষায় সময়ের সঙ্গে গবেষণার ফলপ্রসূতা দেখতে হবে: সফল পরীক্ষা, যাচাইকৃত আবিষ্কার, দক্ষতার উন্নতি এবং সেই উন্নতিতে এআইয়ের অবদান কতটা। যে পরীক্ষা দিয়ে উন্নতি বেছে নেওয়া হয়েছে, তার বাইরেও ফল কাজে লাগছে কি না, সেটিও দেখতে হবে।
কোনো ব্যবস্থা মূল্যায়নকারীকে সন্তুষ্ট করতে খুব ভালো হতে পারে, অথচ আসল উদ্দেশ্য পূরণে ব্যর্থ হতে পারে। তাই পরীক্ষার সংখ্যা যতটা জরুরি, পরীক্ষার মানও ততটাই। এআই পরীক্ষা চালানো সস্তা করলে বিশ্বস্ত মূল্যায়নের প্রয়োজন কমে না, বাড়ে।
অ্যানথ্রপিকের এগিয়ে থাকাকে স্বীকৃতি দিন, অতিরঞ্জন নয়
মূল নিবন্ধের সময়রেখা অনুযায়ী, অ্যানথ্রপিক ৯ নভেম্বর ফ্যাবল ৫.২ ও মিথোস ৫.২ পরিচয় করায়। প্রতিষ্ঠানটির বক্তব্য, অন্তর্নিহিত মডেল এক হলেও সুরক্ষাব্যবস্থা ও প্রবেশাধিকার আলাদা। কারিগরি কাজ ও দক্ষতার উন্নতির দাবিও এসেছে। নির্মাতার এসব বক্তব্য স্বাধীন মূল্যায়নের পাশে রেখে দেখতে হবে।
নির্বাচিত সূচকে ফ্যাবলের ফল ভালো। আমি সেটিকে গুরুত্ব দিই। কিন্তু তাই বলে ক্লডই সেরা নিবন্ধ লিখবে, প্রতিটি স্প্রেডশিট ঠিকভাবে সামলাবে বা সব বাজেটে সবাইকে ছাড়িয়ে যাবে—এমন সিদ্ধান্ত টানি না।
এগিয়ে থাকা একই সঙ্গে অর্থবহ ও সাময়িক হতে পারে। দায়িত্বশীল তুলনা কোনো প্রতিষ্ঠান যা দেখিয়েছে তার স্বীকৃতি দেয়, আবার পরের ফলের ভিত্তিতে সিদ্ধান্ত বদলানোর জায়গাও রাখে।
ওপেনএআইয়ের প্রতিযোগিতা একটি মডেলের নামেই সীমাবদ্ধ নয়
জিপিটি-৬ অ্যাস্ট্রা একটি মডেল; চ্যাটজিপিটি কাজ করার একটি পণ্যপরিবেশ। দুটি বিষয় গুলিয়ে ফেললে তুলনা কম কার্যকর হয়। অ্যাস্ট্রার ঘোষণায় কম্পিউটার ব্যবহার, সফটওয়্যার প্রকৌশল ও পেশাগত কাজের গুরুত্ব ছিল; বিভিন্ন প্রয়োজনের জন্য প্রতিষ্ঠানটির অন্য মডেলও আছে।
আমার কাছে ব্যবহারিক প্রশ্ন হলো, সহকারী কি একটি অনুরোধ থেকে নির্ভরযোগ্যভাবে সম্পূর্ণ কাজ পর্যন্ত পৌঁছাতে পারে? সঠিক ফাইল ব্যবহার করতে পারে? বিন্যাস অক্ষুণ্ন রাখতে পারে? নির্দিষ্ট সীমার মধ্যে পরিবর্তন করে কী ঘটেছে দেখাতে পারে? শেষ হওয়া কাজ এবং আটকে থাকা কাজ আলাদা করে জানাতে পারে?
প্রকাশনা ও ব্যবসায় এসব সক্ষমতা গুরুত্বপূর্ণ। এগুলো ভুলের পরিণতিও বড় করে। ভুল বাক্য সম্পাদনা করা যায়; সংযুক্ত অ্যাপে ভুল কাজ হলে নথি বা অন্য মানুষ ক্ষতিগ্রস্ত হতে পারে। অনিশ্চয়তা স্বীকার করার মানসিকতা তাই সহকারীর ব্যবহারিক মূল্যের অংশ।
চীনের সুযোগ এই সারণিতে প্রথম হওয়ার চেয়ে বড়
এই নির্বাচিত তথ্যচিত্রে কিমির অবস্থান শীর্ষ মার্কিন মডেলগুলোর নিচে। নির্দিষ্ট মডেল ও সূচক নিয়ে এটি ন্যায্য বক্তব্য। কিন্তু চীনের গবেষণার পূর্ণাঙ্গ মূল্যায়ন নয়; প্রতিটি কিউয়েন বা ডিপসিক সংস্করণ সম্পর্কেও চূড়ান্ত কথা বলে না।
মূল নিবন্ধে আলিবাবার কিউয়েন ৩.৮-সহ ডাউনলোডযোগ্য মডেল ওয়েটের কথা আলোচিত হয়েছে। শুধু নির্মাতার অনলাইন সেবায় পাওয়া পণ্যের তুলনায় এটি ভিন্ন সম্ভাবনা তৈরি করে। তবে কোথায় ও কীভাবে ব্যবহার করা যাবে, তা নির্দিষ্ট মডেল ও লাইসেন্সের ওপর নির্ভর করে। ওয়েট উন্মুক্ত হওয়া আর প্রশিক্ষণের সম্পূর্ণ প্রক্রিয়া উন্মুক্ত হওয়া এক নয়।
যুক্তরাষ্ট্র ও চীনের বাইরের প্রতিষ্ঠানের কাছে এই নমনীয়তা গুরুত্বপূর্ণ হতে পারে। নিজস্ব প্রয়োজন অনুযায়ী মডেল বদলানো, অবকাঠামো বেছে নেওয়া বা এক সরবরাহকারীর ওপর নির্ভরতা কমানো—এসবের সুযোগ থাকে। কোনোটিই স্বয়ংক্রিয়ভাবে কম খরচ বা বেশি গোপনীয়তা নিশ্চিত করে না। এগুলো যাচাই করার মতো বিকল্প তৈরি করে।
তাই দুটি সহজ গল্পই আমি এড়িয়ে চলব: কিছু মডেল সহজে পাওয়া যায় বলে চীন ইতিমধ্যে জিতে গেছে; অথবা একটি সর্বাধুনিক সক্ষমতার তুলনায় মার্কিন গবেষণাগার এগিয়ে বলে চীন হেরে গেছে। দুটিই শিল্পের একটি অংশকে পুরো শিল্প বলে ধরে নেয়।
বাংলাদেশের একজন উদ্যোক্তার জন্য এর অর্থ কী?
আমার প্রতিষ্ঠানগুলো কোনো একটি গবেষণাগারের সমর্থক হয়ে দর্শকের আসনে বসে থাকুক, তা চাই না। চাই, আমরা প্রযুক্তি বাছাই, যাচাই ও প্রয়োজনমতো বদলাতে আরও দক্ষ হই।
এর অর্থ গুরুত্বপূর্ণ কাজ অন্য ব্যবস্থায় নেওয়ার সুযোগ রাখা, কোন মডেল কোন ফল তৈরি করেছে তা নথিভুক্ত করা এবং নিজেদের কাজের মতো দায়িত্ব দিয়ে সক্ষমতা যাচাই করা। সাবস্ক্রিপশন বা এপিআইয়ের বিলের সঙ্গে পর্যালোচনার খরচও ধরতে হবে। নতুন নাম আলোচিত হলেই পুরো কর্মপ্রবাহ বদলানোর তাড়না সামলাতে হবে। এআই কীভাবে কর্মপ্রবাহ বদলাচ্ছে, সেই আলোচনাতেও মানুষের ভূমিকা বাদ দেওয়া যায় না।
আগের অনুশীলনের ছোট্ট শিক্ষা ছিল, একটি প্রম্পট সহকারীর কাজ ধরার ধরন দেখাতে পারে, কিন্তু সর্বজনীন বিজয়ী নির্ধারণ করতে পারে না। পরের মূল্যায়নে বাস্তব কাজ বারবার করানো, ব্যর্থতা নথিভুক্ত করা এবং সম্পাদিত চূড়ান্ত ফল বিচার করা দরকার। ওপরে বর্ণিত অ্যাপের অনুশীলন শুরু করার জায়গা, পূর্ণাঙ্গ সংবাদকক্ষের মূল্যায়ন পাস করার সনদ নয়।
পাঠকের প্রাপ্যও একই শৃঙ্খলা। এআইয়ের কোনো দাবির প্রমাণ খুঁজে না পাওয়া গেলে সাবলীল ভাষা সেটিকে উদ্ধার করতে পারে না। মডেলের প্রতিটি উন্নত সংস্করণেও এই নীতি অটুট থাকা উচিত।
আমার রায়: এগিয়ে থাকা বাস্তব, মুকুট স্থায়ী নয়
১৩ নভেম্বরের এই মূল্যায়নে মার্কিন গবেষণাগারগুলোর অবস্থান শক্তিশালী, অ্যানথ্রপিক নির্বাচিত বুদ্ধিমত্তার তুলনায় এগিয়ে এবং গুগলের যুক্তিবিশ্লেষণ, কাজ সম্পাদন ও বিস্তৃত ব্যবহারের সমন্বয় বিশেষ নজরের দাবি রাখে। মডেল ও কাজের পরিবেশ—উভয় ক্ষেত্রেই ওপেনএআই বড় প্রতিযোগী। চীনা নির্মাতারাও গুরুত্বপূর্ণ প্রতিদ্বন্দ্বী; একটি স্কোর দিয়ে তাদের প্রভাব বোঝানো যায় না।
চীনা এআই বনাম মার্কিন এআই প্রতিযোগিতার পরের ধাপ নির্ধারিত হবে গবেষণা কত দক্ষভাবে কাজে লাগার মতো ব্যবস্থায় পরিণত হয় এবং সেই গবেষণার কতটা এআই নিজেই এগিয়ে নিতে পারে, তার ওপর। গুগলের বক্তব্য দ্রুততর এআই উন্নয়নকে গুরুত্বের সঙ্গে আলোচনার বিষয় করে। কিন্তু স্বয়ংক্রিয় স্ব-উন্নয়ন ভবিষ্যৎ নির্ধারণ করে ফেলেছে—এমন ঘোষণা দেওয়ার ভিত্তি নয়।
প্রতিষ্ঠাতা ও প্রধান নির্বাহী হিসেবে আমি এমন অগ্রগতি চাই, যা মানুষের সক্ষমতা ও বেছে নেওয়ার সুযোগ বাড়ায়। মডেল শক্তিশালী হওয়ার সঙ্গে আমাদের বিচারবোধ দুর্বল হলে সুযোগটিই ভুল বুঝেছি। আমার কাছে আসল বিজয়ী সেই পাঠক, স্রষ্টা বা ছোট ব্যবসা, যারা যন্ত্রকে প্রশ্ন করার ক্ষমতা না হারিয়ে আরও ভালো কাজ করতে পারে।