
এআইয়ের পরের যুগে একজনই জিতবে, এমন ধরে নেওয়ার কারণ খুব কম। মার্কিন কোম্পানিগুলোর হাতে টাকা আছে, বড় প্ল্যাটফর্ম আছে, আর এই মুহূর্তের সবচেয়ে শক্তিশালী কয়েকটি ফ্রন্টিয়ার মডেলও তাদেরই। চীনা ডেভেলপাররা আবার দেখিয়ে দিয়েছেন, অনেক বেশি সীমাবদ্ধতার মধ্যেও খুব শক্তিশালী এআই বানানো যায়। তার ওপর মডেলের ওয়েট, মানে প্যারামিটারের মানগুলো, যদি আরও বেশি মানুষের হাতে তুলে দেওয়া হয়, তাহলে সেই মডেল নিজের দেশের বাজার পেরিয়ে দ্রুত অনেক দূর ছড়িয়ে পড়তে পারে।
চীনা এআই বনাম মার্কিন এআই এর মধ্যে কে দৌড়ে টিকতে পারবে সেটিই একমাত্র প্রশ্ন নয় এখন, প্রশ্ন হলো গবেষণাগারের সাফল্যকে কে কম খরচে, ভরসা করার মতো কাজের প্রযুক্তিতে বদলে অনেক মানুষের হাতে পৌঁছে দিতে পারবে। এই হিসাবে এখনো কেউ জিতে যায়নি। তা ছাড়া উত্তরটা সবার জন্য এক নয়। একটা গবেষণাগার যা খুঁজবে, একটা ছোট ব্যবসা তা খুঁজবে না। আর ডেডলাইনের চাপে থাকা একজন লেখকের চাওয়া আবার আলাদা।
এগিয়ে থাকার হিসাব দ্রুত বদলায়
স্ট্যানফোর্ডের ২০২৬ সালের এআই ইনডেক্স দেখাচ্ছে, প্রযুক্তিগত সক্ষমতা খুব দ্রুত বাড়ছে। মূল্যায়নের বেশ কয়েকটি মাপকাঠিতে শীর্ষ মার্কিন আর চীনা মডেলের ফারাকও কমে আসছে। তবে এসব তুলনা আসলে নির্দিষ্ট সময়ে চালানো নির্দিষ্ট কিছু পরীক্ষার ফল। এ দিয়ে কোনো দেশকে স্থায়ীভাবে সেরা বলা যায় না। বাস্তবের সব কাজে মডেলগুলো কেমন করবে, সেটাও এখান থেকে বলে দেওয়া যায় না।
টাকার দিক থেকে যুক্তরাষ্ট্র এখনো অনেক এগিয়ে। এআই ইনডেক্সের হিসাবে ২০২৫ সালে যুক্তরাষ্ট্রে এআই খাতে বেসরকারি বিনিয়োগ ছিল ২৮৫.৯ বিলিয়ন ডলার। চীনে ছিল ১২.৪ বিলিয়ন ডলার। ফারাকটা বিশাল, তবে সংখ্যাটা পড়ার সময় কয়েকটা কথা মাথায় রাখা দরকার। এটা শুধু বেসরকারি বিনিয়োগ, দেশের মোট খরচ নয়। সরকারি সহায়তার সব রূপ এখানে ধরা নেই। আর প্রতিটি ডলার কতটা কাজে লাগছে, সেটাও এই হিসাব বলে না।
শীর্ষ মার্কিন ও চীনা মডেল পাশাপাশি
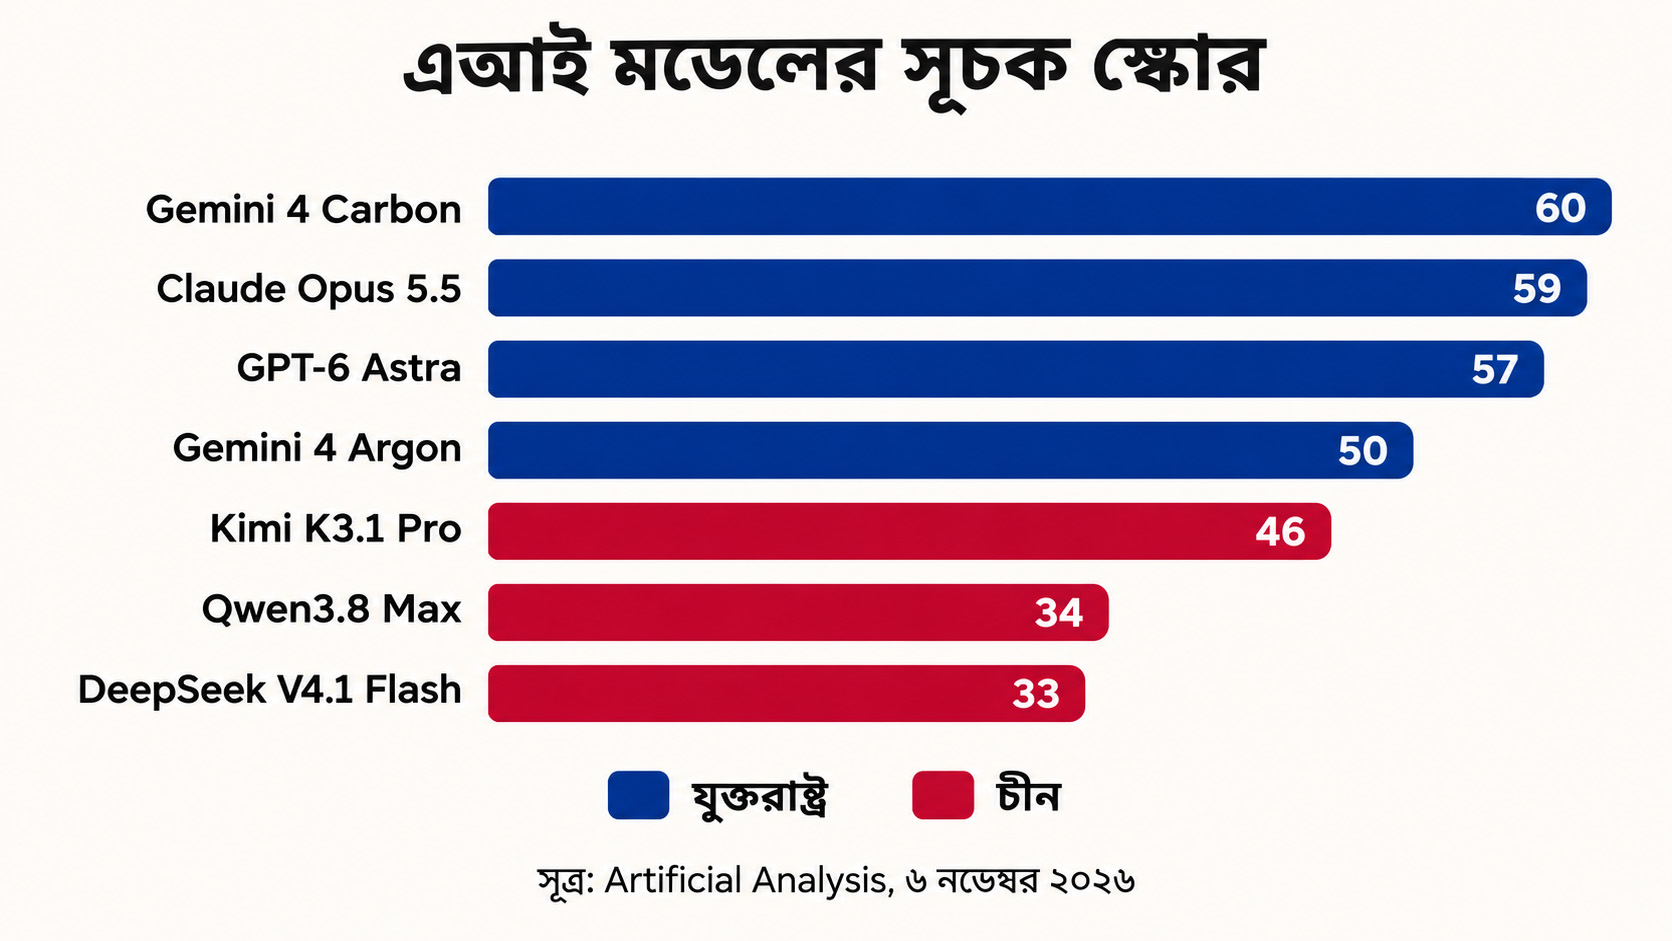
নিচের সারণিটি Editorialge-এর নিজেদের পরীক্ষা নয়। এটি একটি স্বাধীন বেঞ্চমার্ক থেকে নেওয়া নির্দিষ্ট দিনের চিত্র: Artificial Analysis-এর Intelligence Index v5.0.1, যা কয়েকটি আলাদা মূল্যায়নের ফল মিলিয়ে তৈরি। স্কোরগুলো সূচকের পয়েন্ট, শতাংশ নয়। মডেল, সেটিংস, লিডারবোর্ড সবই বদলায়। তাই আপনি যখন এটা পড়ছেন, তখন সারণির মডেলটিই ওই কোম্পানির সর্বশেষ মডেল না-ও হতে পারে।
| নির্মাতা ও মডেল | দেশ | সূচকের স্কোর |
|---|---|---|
| Google: Gemini 4 Carbon (high) | মার্কিন যুক্তরাষ্ট্র | 60 |
| Anthropic: Claude Opus 5.5 (max) | মার্কিন যুক্তরাষ্ট্র | 59 |
| OpenAI: GPT-6 Astra (max) | মার্কিন যুক্তরাষ্ট্র | 57 |
| Google: Gemini 4 Argon (high) | মার্কিন যুক্তরাষ্ট্র | 50 |
| Moonshot AI: Kimi K3.1 Pro | চীন | 46 |
| Alibaba: Qwen3.8 Max (0902) | চীন | 34 |
| DeepSeek: DeepSeek V4.1 Flash 1017 (max) | চীন | 33 |
সূত্র: Artificial Analysis Intelligence Index v5.0.1, তথ্য দেখা হয়েছে ৬ নভেম্বর ২০২৬। স্কোরগুলো
সূচকের পয়েন্ট, শতাংশ নয়। এখানে বাছাই করা কয়েকটি মডেলের নির্দিষ্ট সংস্করণ ও সেটিং দেখানো হয়েছে। এটি পুরো লিডারবোর্ড নয়, দামের ভিত্তিতে সমান তুলনাও নয়। ফলব্যাক (দরকার হলে বিকল্প ব্যবস্থায় চলে যাওয়া) আর রিজনিং সেটিং ফলাফলে প্রভাব ফেলে। এই স্কোর দিয়ে লেখার মান সরাসরি মাপা যায় না। আর আপনি যে চ্যাট সেবা ব্যবহার করেন, সেখানে অন্য মডেলও চলতে পারে।
সারণিতে দেখা যাচ্ছে, এই দিনের হিসাবে প্রথম চারটি জায়গাই মার্কিন মডেলের। সবার ওপরে Gemini 4 Carbon (high), ৬০ পয়েন্ট। মাত্র এক পয়েন্ট পেছনে Claude Opus 5.5 (max), তারপর ৫৭ পয়েন্টে GPT-6 Astra (max) আর ৫০ পয়েন্টে Gemini 4 Argon (high)। চীনা মডেলগুলোর মধ্যে সবচেয়ে ওপরে Kimi K3.1 Pro, ৪৬ পয়েন্ট। Qwen3.8 Max (0902) পেয়েছে ৩৪, DeepSeek V4.1 Flash 1017 (max) ৩৩। স্কোরগুলো এসেছে সূচকের নিজস্ব পদ্ধতিতে নির্দিষ্ট সংস্করণ যাচাই করে। কোন কোম্পানি সব মডেল মিলিয়ে কোথায় দাঁড়িয়ে, এটা সেই তালিকা নয়।
স্কোরের ফারাক নির্ভর করে কোন মডেল বাছা হয়েছে, মূল্যায়নের জন্য কোন ফল পাওয়া গেছে, রিজনিং সেটিং কী ছিল আর v5.0.1 সংস্করণে স্কোর কীভাবে গোনা হয়, তার ওপর। পুরোনো কোনো লেখা বা অন্য সারণিতে হয়তো সূচকের আগের সংস্করণ, মডেলের অন্য সংস্করণ বা অন্য দিনের তথ্য আছে। পদ্ধতি না মিলিয়ে সেসব স্কোর জোড়া দিয়ে র্যাঙ্কিং বানানো ঠিক হবে না।
Google আর Alibaba-র কথাও এখানে আলাদা করে বলা দরকার। মার্কিন ফ্রন্টিয়ার এআইয়ের লড়াইয়ে Google-এর Gemini মডেলগুলো ভালোভাবেই আছে। চীনের দিকে Alibaba-র Qwen প্রতিযোগিতার পরিসর আরও বাড়িয়েছে। ২০২৬ সালের অক্টোবরে কোম্পানির আর্থিক ফলাফল নিয়ে কথা বলার সময় Google-এর প্রধান নির্বাহী সুন্দর পিচাই বলেছিলেন, Argon ও Carbon নিয়ে তাঁরা “এআইয়ের সর্বাধুনিক পর্যায়ে নেতৃত্ব দিতে পেরে উচ্ছ্বসিত।” কথাটা অবশ্য Google-এর নিজের মূল্যায়ন। ওপরের স্বাধীন স্কোরগুলো তার চেয়ে অনেক সরু একটা প্রশ্নের উত্তর দেয়: নির্দিষ্ট বেঞ্চমার্কে কে কেমন করল।
বেঞ্চমার্কের তুলনা সরাসরি দেখতে চাইলে: Gemini Carbon বনাম Qwen | Gemini Argon বনাম Qwen | Claude বনাম Kimi | GPT বনাম DeepSeek
তবে কোন এআই সহকারী একটা নিউজরুমের জন্য সবচেয়ে ভালো সূচনা লিখবে, বা কোনটা সবচেয়ে ভরসাযোগ্যভাবে সূত্র যাচাই করবে, তা বেঞ্চমার্কের স্কোর বা কোম্পানির দাবি দেখে বোঝা যায় না। সেটা জানতে হলে নির্দিষ্ট কাজ ধরে আলাদা পরীক্ষা করতে হয়, আর সেই পরীক্ষার পুরো বিবরণ লিখে রাখতে হয়।
যুক্তরাষ্ট্র কোথায় এগিয়ে
মার্কিন এআই কোম্পানিগুলোর পেছনে আছে পুরোনো, গোছানো ভেঞ্চার ক্যাপিটালের বাজার, ক্লাউড অবকাঠামো, গবেষণাপ্রতিষ্ঠান আর বড় বড় কোম্পানির সঙ্গে বহু বছরের সম্পর্ক। লাখ লাখ মানুষ রোজ যে সফটওয়্যার ব্যবহার করেন, তার ভেতরেই এরা নিজেদের মডেল জুড়ে দিতে পারে। ফলে ল্যাবে মডেল কত ভালো করল, সেটা যতটা জরুরি, মডেলটা গ্রাহকের কাছে পৌঁছে দেওয়ার ক্ষমতাও এখন ঠিক ততটাই জরুরি। সেমিকন্ডাক্টরের সরবরাহব্যবস্থা পুরো দুনিয়ায় ছড়ানো হলেও উন্নত চিপের নকশা আর তার সফটওয়্যারে যুক্তরাষ্ট্রের দাপট রয়েছে।
কিন্তু টাকা আর সম্পদ থাকলেই চিরকাল এগিয়ে থাকা যায় না। ফ্রন্টিয়ার এআই নিয়ে গবেষণা খুব খরুচে। মডেল চালানোর খরচ বেশি হলে সেটা বেশি মানুষ ব্যবহার করতে পারে না। কোনো কোম্পানি কঠিন বেঞ্চমার্কে প্রথম হয়েও গ্রাহক হারাতে পারে, যদি প্রতিযোগী অনেক কম খরচে ‘যথেষ্ট ভালো’ ফল দিতে পারে।
চীনের জোর: দক্ষতা আর মানুষের কাছে পৌঁছানো
চীনা ডেভেলপাররা মডেলের সক্ষমতা আর বাস্তব ব্যবহার, দুই জায়গাতেই কড়া প্রতিযোগিতা তৈরি করেছেন। ওপেন ওয়েট মডেল ছাড়ার ফলে বাইরের প্রতিষ্ঠান লাইসেন্সের শর্ত মেনে মডেলটা নিজের মতো বদলে নিতে পারে, নিজের অবকাঠামোতে চালাতে পারে। তবে এখানে একটা বিষয় গুলিয়ে ফেলা সহজ। ওয়েট খোলা মানেই প্রশিক্ষণের ডেটা, কোড বা পুরো ব্যবস্থার বাকি অংশও খোলা, তা কিন্তু নয়।
বাংলাদেশ, আফ্রিকা বা লাতিন আমেরিকার কোনো প্রতিষ্ঠানের কাছে দুই দেশের লড়াইয়ের চেয়ে এই পার্থক্যটাই হয়তো বেশি জরুরি। তাদের প্রশ্নগুলো অনেক বেশি মাটির কাছাকাছি। নিজেদের পছন্দের পরিবেশে মডেলটা চালানো যাবে তো? যে কাজে লাগাতে চাই, লাইসেন্স সেটার অনুমতি দেয় কি? সব মিলিয়ে বসাতে খরচ কত পড়বে? আরেকটা কথা। ওপেন ওয়েট মডেল হাতে পেলেই তথ্যের গোপনীয়তা বা নিরাপত্তা নিশ্চিত হয়ে যায় না। সেটিংস কীভাবে করা হয়েছে আর মডেলটা কোথায় হোস্ট করা, সেটাও সমান গুরুত্বপূর্ণ।
চিপ আর রপ্তানি নিয়ন্ত্রণ: খেলার গতি বদলায়, ফল ঠিক করে না
উন্নত কম্পিউটিং হার্ডওয়্যার হাতে পাওয়ার সীমাবদ্ধতা এখনো কৌশলগত দিক থেকে বড় ব্যাপার। মার্কিন রপ্তানি নিয়ন্ত্রণ চীনের সঙ্গে চিপের কিছু লেনদেনে প্রভাব ফেলছে, আবার নীতি ও লাইসেন্সের শর্তও বদলাচ্ছে। ২০২৬ সালের জানুয়ারিতে মার্কিন বাণিজ্য বিভাগ কিছু নির্দিষ্ট সেমিকন্ডাক্টর রপ্তানির আবেদন পর্যালোচনার নীতি সংশোধন করেছে। এটাকে সব এআই চিপের ওপর সরাসরি, স্থায়ী নিষেধাজ্ঞা বলা ভুল হবে।
বিধিনিষেধে খরচ বাড়ে, অনিশ্চয়তাও বাড়ে। এর চাপে মডেলের নকশা, হার্ডওয়্যার জোগাড় আর মডেল চালানোর ধরনও বদলে যেতে পারে। কিন্তু এর কোনোটাই শেষ পর্যন্ত কে জিতবে তা ঠিক করে দেয় না। চিপ পাওয়ার সুযোগ, জ্বালানি, উৎপাদনক্ষমতা আর দক্ষ গবেষক, সময়ের সঙ্গে এগুলো একটা আরেকটাকে প্রভাবিত করতে থাকে।
লেখকের টেবিলে চীনা আর মার্কিন এআই
লেখক বা প্রকাশক হিসেবে নিজে যাচাই করতে চাইলে শুরু করুন একটা সত্যিকারের লেখার কাজ দিয়ে। ChatGPT, DeepSeek, Claude, Kimi, Gemini আর Qwen-কে একই নির্দেশনা দিন, সঙ্গে একই তথ্যসূত্রের সংকলন। এই লেখার জন্য আমরা তিনটি জোড়া বেছে নিয়েছি: ChatGPT বনাম DeepSeek, Claude বনাম Kimi, আর Gemini বনাম Qwen। কোন সেবা ব্যবহার করছেন, মডেলের নাম দেখা গেলে সেটা, সাবস্ক্রিপশন প্ল্যান, তারিখ, সেটিংস, ইন্টারনেট ব্রাউজিং চালু ছিল কি না আর কী কী ফাইল আপলোড করেছেন, সব লিখে রাখুন। একটা কথা মনে রাখবেন: সেবার নাম দেখে বোঝা যায় না, বেঞ্চমার্কে যে মডেলটা পরীক্ষা হয়েছে, ঠিক সেটাই সেখানে চলছে কি না।
তারপর একজন মানুষ সম্পাদককে দিয়ে লেখাগুলো পড়ান। তিনি দেখবেন তথ্যে ভুল আছে কি না, কোনো সূত্র বানানো কি না, জরুরি কিছু বাদ পড়েছে কি না, আর লেখাটা পরিষ্কার কি না। প্রকাশযোগ্য করতে কত সময় লাগল, সেটাও মাপুন। কয়েকটা আলাদা বিষয়ে একই পরীক্ষা চালান। ব্রাউজিং, পেইড সুবিধা বা সেটিংসে কোনো পার্থক্য থাকলে সেটাও লিখে রাখুন। এমন ছোট পরীক্ষা সম্পাদকীয় সিদ্ধান্ত নেওয়ার জন্য কাজের প্রমাণ দেয়। কিন্তু এর ভিত্তিতে কোনো মডেলকে সবার জন্য সেরা বলা যায় না, বৈজ্ঞানিকভাবে তো নয়ই।
আমরা এই পরীক্ষা চালিয়েছি ২০২৬ সালের ৬ নভেম্বর। ছয়টি এআই সহকারীর প্রতিটিতে নিজেদের অ্যাকাউন্টে লগইন করে একই ১০০ শব্দের লেখার নির্দেশনা দিয়েছি, আর প্রতিটা উত্তর সংরক্ষণ করেছি। কাজ ছিল এই লেখারই একটা সূচনা লেখা, যেখানে বোঝাতে হবে লেখক আর ছোট ব্যবসার কাছে এই প্রতিযোগিতা কেন জরুরি। শর্ত ছিল, কোনো পরিসংখ্যান, উদ্ধৃতি বা ব্যক্তিগত অভিজ্ঞতা বানানো যাবে না। সব সেবার ইন্টারফেসে মডেলের সঠিক সংস্করণ দেখা যায়নি। যেগুলোতে দেখা গেছে, তা নিচের ছবির ক্যাপশনে দেওয়া আছে।
ChatGPT বনাম DeepSeek
দুটোই লেখক আর ছোট ব্যবসা, দুই পাঠকগোষ্ঠীর কথা আলাদা করে বলেছে। ChatGPT-তে চলেছে GPT-6.1 Sol (Medium)। এক চেষ্টাতেই প্রায় ১০০ শব্দের একটা উত্তর দিয়েছে। শুরু করেছে একজন লেখকের সম্পাদনার অপেক্ষায় জমে থাকা লেখা আর একটা ছোট দোকানের ইনবক্সের ছবি দিয়ে। শেষ করেছে এমন টুলের কথা বলে, যেগুলো মানুষের “কেনার সামর্থ্য আছে, যেগুলোর ওপর তারা আস্থা রাখতে পারে এবং যেগুলো তাদের চলমান কাজের সঙ্গে মানিয়ে নিতে পারে।”
DeepSeek-ও একই শব্দসীমার ভেতরে থেকেছে, তবে জোর দিয়েছে অন্য জায়গায়: খরচ, নির্ভরযোগ্যতা, গোপনীয়তা, আর এক পরিবেশ থেকে আরেক পরিবেশে সহজে নিয়ে যাওয়ার সুবিধা। উত্তর দেওয়ার আগে চার সেকেন্ডের একটা রিজনিং ধাপও দেখা গেছে। নির্দেশনায় স্পষ্ট মানা ছিল, আর দুটোর কোনোটাই পরিসংখ্যান বা উদ্ধৃতি বানায়নি। তবু সম্পাদকের কাজ দুই ক্ষেত্রেই একই রয়ে যায়। কাঠামো বেশ সাদামাটা, একটা নিউজরুম আরও ধারালো শুরু চাইবে। আর মূল যুক্তি দাঁড় করাতে কোনো পরিসংখ্যান লাগলে সেটা নিতে হবে যাচাই করা সূত্র থেকে, মডেলের সাধারণ জ্ঞান থেকে নয়।
Claude বনাম Kimi
Claude Sonnet 5.5 (High) লিখেছে সংযত, প্রবন্ধের ঢঙে একটা অনুচ্ছেদ। পাঠকের জন্য আসল বিষয়টা সোজাসুজি বলেছে: মৌলিক কাজ কীভাবে “মূল্যায়ন করা হয়, তার স্বীকৃতি দেওয়া হয় এবং সুরক্ষা নিশ্চিত করা হয়।” ১০০ শব্দের সীমাও মেনেছে। Kimi চলেছে Instant High মোডে। ভাষা প্রায় একই রকম, তবে সম্ভাব্য পরিণতির দিকে আরেকটু এগিয়েছে। প্রশ্ন তুলেছে, “বুদ্ধিমত্তা যখন অবকাঠামোতে পরিণত হয়, তখন তা ব্যবহারের সুযোগ, শ্রম ও আস্থার ক্ষেত্রে কার নিয়ম কার্যকর হবে?”
Kimi-র উত্তরে রিজনিংয়ের ধাপও চোখে পড়েছে, আর শেষ দিকে সুরটা একটু বেশি সম্পাদকীয় হয়ে গেছে। Claude সে তুলনায় ঠান্ডা মাথার, ব্যাখ্যার দিকে বেশি মন দিয়েছে। সূত্র ছাড়া কোনো সংখ্যা বা উদ্ধৃতি দুটোর কেউই ব্যবহার করেনি। প্রথম জোড়ার মতো এখানেও সম্পাদকের কথাটা পরিষ্কার: বাড়তি তথ্য সংগ্রহ আর রিপোর্টিং ছাড়া এর কোনোটাই ছাপা যাবে না। এগুলো লেখার শুরু মাত্র, অনুসন্ধানের ফল নয়।
Gemini বনাম Qwen
Gemini শুরু করেছে লেখার শিরোনাম দিয়ে, তারপর দুই অনুচ্ছেদ। সূচনাতেই সূত্রসহ একটা পরিসংখ্যান দিয়েছে: ২০২৬ সালের মার্চে শীর্ষ মার্কিন আর চীনা মডেলের সক্ষমতার ফারাক কমে ২.৭ শতাংশে নেমেছে। সূত্র হিসেবে আছে স্ট্যানফোর্ড HAI-এর ২০২৬ সালের এআই ইনডেক্সের ছোট একটা লেবেল, সঙ্গে কম্পিউটিং সক্ষমতার ফারাক নিয়ে পটভূমি বোঝানো একটা ভিডিওর লিংক।
এখানে একটু সাবধানে বলা দরকার। ছয়টি মডেলকেই বলা হয়েছিল পরিসংখ্যান বানিয়ে না লিখতে। Gemini সেই অর্থে নির্দেশ মেনেছে, কারণ সংখ্যাটা বানানো নয়, তার সূত্র আছে। কিন্তু বাকিরা যেখানে কোনো সংখ্যাই দেয়নি, Gemini সেখানে একটা যোগ করেছে। এতে সম্পাদকের কাজ বদলে যায়। এখন আর শুধু ‘বানানো কি না’ দেখলে চলবে না, খুঁজে দেখতে হবে উল্লেখ করা সূত্রটা আসলেই এই দাবি সমর্থন করে কি না।
Qwen চলেছে Qwen3.7-Plus হিসেবে, আর ছয়টির মধ্যে সবচেয়ে ভারসাম্যপূর্ণ উত্তরটা এসেছে এখান থেকেই। কয়েকটা বাক্যে ছিল লেখকদের প্রসঙ্গ: মেধাস্বত্ব, সৃজনশীল কাজের স্বয়ংক্রিয়করণ, সাংস্কৃতিক প্রভাব। বাকি বাক্যগুলোতে ছোট ব্যবসার কথা: সাশ্রয়ী টুল আর বাজারে প্রতিযোগিতা করার সক্ষমতা। কোনো সংখ্যা ব্যবহার করেনি। তবু ছাপার আগে একজন পর্যালোচক Qwen-এর কাছে আরও স্পষ্ট, ধারালো মূল বক্তব্য চাইবেন। আর Gemini-র দেওয়া পরিসংখ্যানটা আলাদা করে যাচাই করতে চাইবেন।
পুরো ব্যাপারটা একই দিনে একই নির্দেশনায় ছয়টি সহকারীর উত্তর থেকে পাওয়া একটা মুহূর্তের ছবি, কোনো রায় নয়। একটা নির্দেশনা দিয়ে বিভিন্ন কোম্পানির মডেলের লেখার মানে র্যাঙ্কিং করা যায় না। আর আপনার চ্যাট উইন্ডোতে যে মডেল চলছে, সেটা ওপরের সারণির মডেল থেকে আলাদা হতে পারে।
লেখক আর এআই প্ল্যাটফর্মের প্রতিষ্ঠাতা হিসেবে যা দেখি
আমি লেখক ও সাংবাদিক, আবার ImagineLab.art-এর প্রতিষ্ঠাতাও। এআই দিয়ে লেখার টুল আমি বিচার করি একটা সোজা প্রশ্নে: এটা কি মানুষকে এমন লেখা তৈরিতে সাহায্য করে, যার ওপর পাঠক ভরসা করতে পারেন? সুন্দর করে লেখা একটা অনুচ্ছেদ কাজে লাগে, সন্দেহ নেই। কিন্তু ওটা কেবল শুরু। তারপরও সম্পাদককে তথ্য মেলাতে হয়, ঠিক প্রেক্ষাপটটা বেছে নিতে হয়, আর দেখতে হয় ভাষাটা পাঠকের কাজে আসছে কি না।
প্রকাশনা আর এআই প্ল্যাটফর্ম, দুই জায়গায় কাজ করেছি বলেই আমার দৃষ্টিভঙ্গি এমন। লেখককে যেসব সিদ্ধান্ত নিতে হয়, আমি সেগুলোর দিকেই বেশি তাকাই। নির্দিষ্ট কাজের জন্য কোন মডেল, তার দাবি কীভাবে যাচাই হবে, একটা উত্তর কতটা ঘষামাজা চায়। শুধু বেঞ্চমার্কে এগিয়ে আছে বলে, বা অমুক দেশের তৈরি বলে, আমি কোনো মডেল দিয়ে লেখাব না। কোনটা ঠিক, তা নির্ভর করে কাজের ধরন, মডেলটা হাতে পাওয়া যায় কি না, খরচ কত, আর পর্যালোচনার পর শেষ লেখাটা কেমন দাঁড়াল তার ওপর।
এই লেখার পরীক্ষায় ছয়টি সহকারীকেই আমি একই নির্দেশনা দিয়েছি এবং সব উত্তর রেখে দিয়েছি। কিন্তু এক দিনের এক নির্দেশনায় শুধু এটুকু বোঝা যায়, কোন মডেল ওই একটা কাজ কীভাবে করল। সাধারণভাবে কে সবচেয়ে ভালো লেখে, সে উত্তর এখানে নেই।
মডেল বাছার আগে যা দেখবেন
প্রথমে নির্ভরযোগ্যতা। মডেলটা কি এমন সূত্র দেখাতে পারে, যা সত্যিই তার কথাকে সমর্থন করে? খুব সাবলীল উত্তরেও বানানো উদ্ধৃতি বা পুরোনো পরিসংখ্যান লুকিয়ে থাকতে পারে। তারপর দেখুন আপনার কাজের ধরনের সঙ্গে মেলে কি না। ডকুমেন্ট নিয়ে কাজ, দল মিলে কাজ, একাধিক ভাষা, এখনকার টুলের সঙ্গে সংযোগ, এসব অনেক সময় একটা সামগ্রিক স্কোরের চেয়ে বেশি গুরুত্বপূর্ণ।
খরচ আর সেবাটা হাতের নাগালে আছে কি না, সেটাও খতিয়ে দেখুন। সাবস্ক্রিপশনের দাম, ব্যবহারের সীমা, এপিআইয়ের খরচ, কোন অঞ্চলে সেবাটা পাওয়া যায়, সবই বদলায়। সেবাদাতার তথ্য ব্যবহারের শর্ত আর নিরাপত্তা সেটিংসও বদলায়। গোপন কোনো নথি এআইতে দেওয়ার আগে এগুলো জানা জরুরি। মডেলটা কোন দেশে তৈরি, সেটা জেনে বোঝা যায় না একটা নির্দিষ্ট সেবা আপনার তথ্য কীভাবে রাখে। তবে সেবাটা কোন নীতিতে চলে, কোন দেশের আইনের আওতায় পড়ে আর কোথায় হোস্ট করা, সেগুলো মন দিয়ে দেখা উচিত।
শেষে দেখুন, আপনার কাজটার জন্য মডেলটা কতটা মানানসই। নতুন আইডিয়া বের করতে কম খরচের একটা মডেলই যথেষ্ট হতে পারে। কঠিন বিশ্লেষণে আবার দামি মডেলের পেছনে খরচটা পুষিয়ে যেতে পারে। সেবাদাতা যে-ই হোক, তথ্য, উদ্ধৃতি আর স্পর্শকাতর সিদ্ধান্তে মানুষের চোখ বুলানো ছাড়া চলবে না।
সামনে তিনটি সম্ভাব্য পথ
প্রথম পথে, ফ্রন্টিয়ার এআইয়ে যুক্তরাষ্ট্রই এগিয়ে থাকবে। পুঁজি আর কম্পিউটিংয়ের জোরে মার্কিন কোম্পানিগুলো অত্যাধুনিক মডেল বানানো আর বড় প্রতিষ্ঠানের কাছে সেগুলো পৌঁছে দেওয়ার দৌড়ে সামনে থাকবে। তবে এর জন্য বিনিয়োগ চালিয়ে যেতে হবে, আর প্রযুক্তিকে এমন পণ্যে রূপ দিতে হবে, যা মানুষ কিনতে পারে।
দ্বিতীয় পথে, ব্যাপক ব্যবহারে চীন এগিয়ে যাবে। চীনা ডেভেলপার আর তাঁদের অংশীদারেরা কাজের, তুলনামূলক সস্তা বা ওপেন ওয়েট মডেল চারদিকে ছড়িয়ে দেবেন। সে ক্ষেত্রে কোনো বেঞ্চমার্কে প্রথম হওয়ার চেয়ে বেশি দাম পাবে, মডেলটা কত দূর ছড়ানো গেল আর কত সহজে নিজের মতো বদলে নেওয়া যায়। তবু বাস্তবে সাফল্য নির্ভর করবে পণ্যের মান, মানুষের আস্থা আর স্থানীয় নিয়মকানুনের ওপর।
তৃতীয় পথে, নেতৃত্ব ভাগ হয়ে যাবে। গবেষণা, চিপ, হোস্টিং, অ্যাপ্লিকেশন কিংবা ওপেন ওয়েট মডেল ঘিরে গড়ে ওঠা প্রযুক্তি ব্যবস্থা, একেক জায়গায় একেক কোম্পানি বা দেশ দাপট দেখাবে। আমার ধারণা, এটাই সবচেয়ে বেশি সম্ভাব্য। এআই একটা পুরো সরবরাহব্যবস্থা, একটা শিল্প। একটা ফিনিশিং লাইনের দিকে সবার দৌড়ের ছবিটা এখানে খাটে না।
লাভটা কার ঘরে যাবে
এআইকে শুধু চীন আর যুক্তরাষ্ট্রের লড়াই হিসেবে দেখলে যাঁরা আসলে এটা ব্যবহার করছেন, তাঁরা আড়ালে পড়ে যান। একজন প্রকাশক চান নির্ভুল প্রতিবেদন আর ভরসার সূত্র। একটা ছোট ব্যবসা চায় এমন খরচে নির্ভরযোগ্য কাজ, যা দীর্ঘদিন টানা যায়। একজন শিক্ষার্থী চায় সঠিক আর সহজ ব্যাখ্যা, যা আত্মবিশ্বাসী একটা উত্তর দিয়ে থেমে যায় না, বিষয়টা সত্যিই বুঝতে শেখায়।
প্রতিযোগিতার ফলে শক্তিশালী টুল সস্তা হতে পারে। কিন্তু ব্যবহারকারীর লাভ তখনই, যখন তিনি দাবিগুলো যাচাই করতে পারবেন, খরচের হিসাব বুঝবেন আর নিজের তথ্য সুরক্ষিত রাখতে পারবেন। নীতিনির্ধারকদের দিক থেকে দরকার উদ্ভাবন, নিরাপত্তা আর জবাবদিহির মধ্যে ভারসাম্য। প্রযুক্তির ক্ষমতা থাকলেই তা জনগণের কাজে আসবে, এমন ধরে নেওয়ার কারণ নেই।
তাহলে দাঁড়াল কোথায়
এই পর্বে যুক্তরাষ্ট্র ঢুকেছে বড় সুবিধা নিয়ে: পুঁজি, অবকাঠামো আর ফ্রন্টিয়ার এআই তৈরিতে এগিয়ে থাকা। চীন দেখিয়েছে, প্রতিযোগিতায় টেকার মতো ক্ষমতা তার আছে। আলাদা ব্যবসায়িক কৌশল আর মডেল ছাড়ার আলাদা পদ্ধতিতে সে এআইকে অনেক মানুষের হাতে পৌঁছে দিতেও পারছে। কিন্তু এখন পর্যন্ত যে প্রমাণ হাতে আছে, তাতে কাউকে স্থায়ী বিজয়ী বলার উপায় নেই।
আমার ধারণা, একসঙ্গে অনেকগুলো মাঠে নেতৃত্বের লড়াই চলবে। পাঠক আর ব্যবসার জন্য সবচেয়ে কাজের পথটা তাই খুব সাদামাটা। নিজের আসল কাজে টুলগুলো চালিয়ে দেখুন, সেগুলো যা লিখে বা বানিয়ে দেয় তা যাচাই করুন, আর যে টুল রোজকার কাজে ভরসা অর্জন করতে পারে, সেটাই বেছে নিন।