
JavaScript-নির্ভর একটি ওয়েবসাইট ব্রাউজারে ঠিকভাবে দেখা গেলেও Google Search-এ তার গুরুত্বপূর্ণ লেখা, পণ্যের তথ্য বা নতুন URL প্রত্যাশামতো নাও আসতে পারে। তবে কোনো পেজ র্যাংক না করলেই JavaScript-কে দায়ী করা ঠিক নয়।
JavaScript SEO রেন্ডারিং যাচাইয়ের প্রথম কাজ হলো সমস্যাটি কোন পর্যায়ে হচ্ছে, তা আলাদা করা। Googlebot URL-টি ক্রল করতে পারছে কি না, JavaScript চালানোর পর প্রয়োজনীয় কনটেন্ট পাচ্ছে কি না এবং URL-টি ইনডেক্স হওয়ার উপযুক্ত কি না—এই তিনটি বিষয় আগে দেখতে হবে।
Google Search JavaScript চালাতে পারে এবং রেন্ডার করা HTML থেকে কনটেন্ট প্রক্রিয়া করে। তবে গুগলের ক্রলার ও ওয়েব রেন্ডারিং ব্যবস্থার কিছু সীমাবদ্ধতা আছে। তাই সাইটে JavaScript ব্যবহার করা হয়েছে কি না, সেটি মূল প্রশ্ন নয়; গুগল শেষ পর্যন্ত কী দেখতে পাচ্ছে, সেটিই বেশি গুরুত্বপূর্ণ।
ক্রলিং, রেন্ডারিং ও ইনডেক্সিং একসঙ্গে গুলিয়ে ফেলবেন না
JavaScript SEO সমস্যার বড় একটি কারণ হলো ভুল জায়গায় সমস্যা খোঁজা। ক্রলিং, রেন্ডারিং ও ইনডেক্সিং তিনটি আলাদা ধাপ।
ক্রলিং (Crawling): Googlebot একটি URL খুঁজে পায় এবং সার্ভার থেকে পেজটি আনার চেষ্টা করে। robots.txt দিয়ে URL বন্ধ করা থাকলে, সার্ভার ত্রুটি হলে বা লগইন ছাড়া কনটেন্ট পাওয়া না গেলে এই ধাপেই সমস্যা হতে পারে।
রেন্ডারিং (Rendering): JavaScript-নির্ভর পেজে গুগল প্রয়োজন হলে JavaScript চালিয়ে রেন্ডার করা HTML তৈরি করে। ক্লায়েন্ট-সাইড রেন্ডারিং (CSR) ব্যবহার করা সাইটে প্রাথমিক HTML-এর মধ্যে মূল কনটেন্ট না থাকলে এই ধাপটি বিশেষভাবে গুরুত্বপূর্ণ।
ইনডেক্সিং (Indexing): গুগল পেজের কনটেন্ট, মেটাডেটা, canonical সংকেত এবং অন্যান্য তথ্য বিশ্লেষণ করে কোন URL ইনডেক্সে রাখা হবে, তা নির্ধারণ করে।
কোনো পেজ সফলভাবে ক্রল বা রেন্ডার হলেই সেটি ইনডেক্স হবে—এমন নিশ্চয়তা নেই।
গুগলের JavaScript SEO ডকুমেন্টেশন অনুযায়ী, সাধারণভাবে 200 HTTP status পাওয়া পেজ রেন্ডারিংয়ের সারিতে যেতে পারে, যদি robots meta tag বা HTTP header গুগলকে সেটি ইনডেক্স না করতে বলে। 404-এর মতো non-200 response পাওয়া গেলে রেন্ডারিং এড়িয়ে যাওয়া হতে পারে।
তাই “গুগল URL আনতেই পারছে না” এবং “URL আনতে পারছে, কিন্তু রেন্ডার করা HTML-এ মূল লেখা পাচ্ছে না”—এই দুই সমস্যার সমাধান আলাদা।
Google Search Console দিয়ে পরীক্ষা শুরু করুন
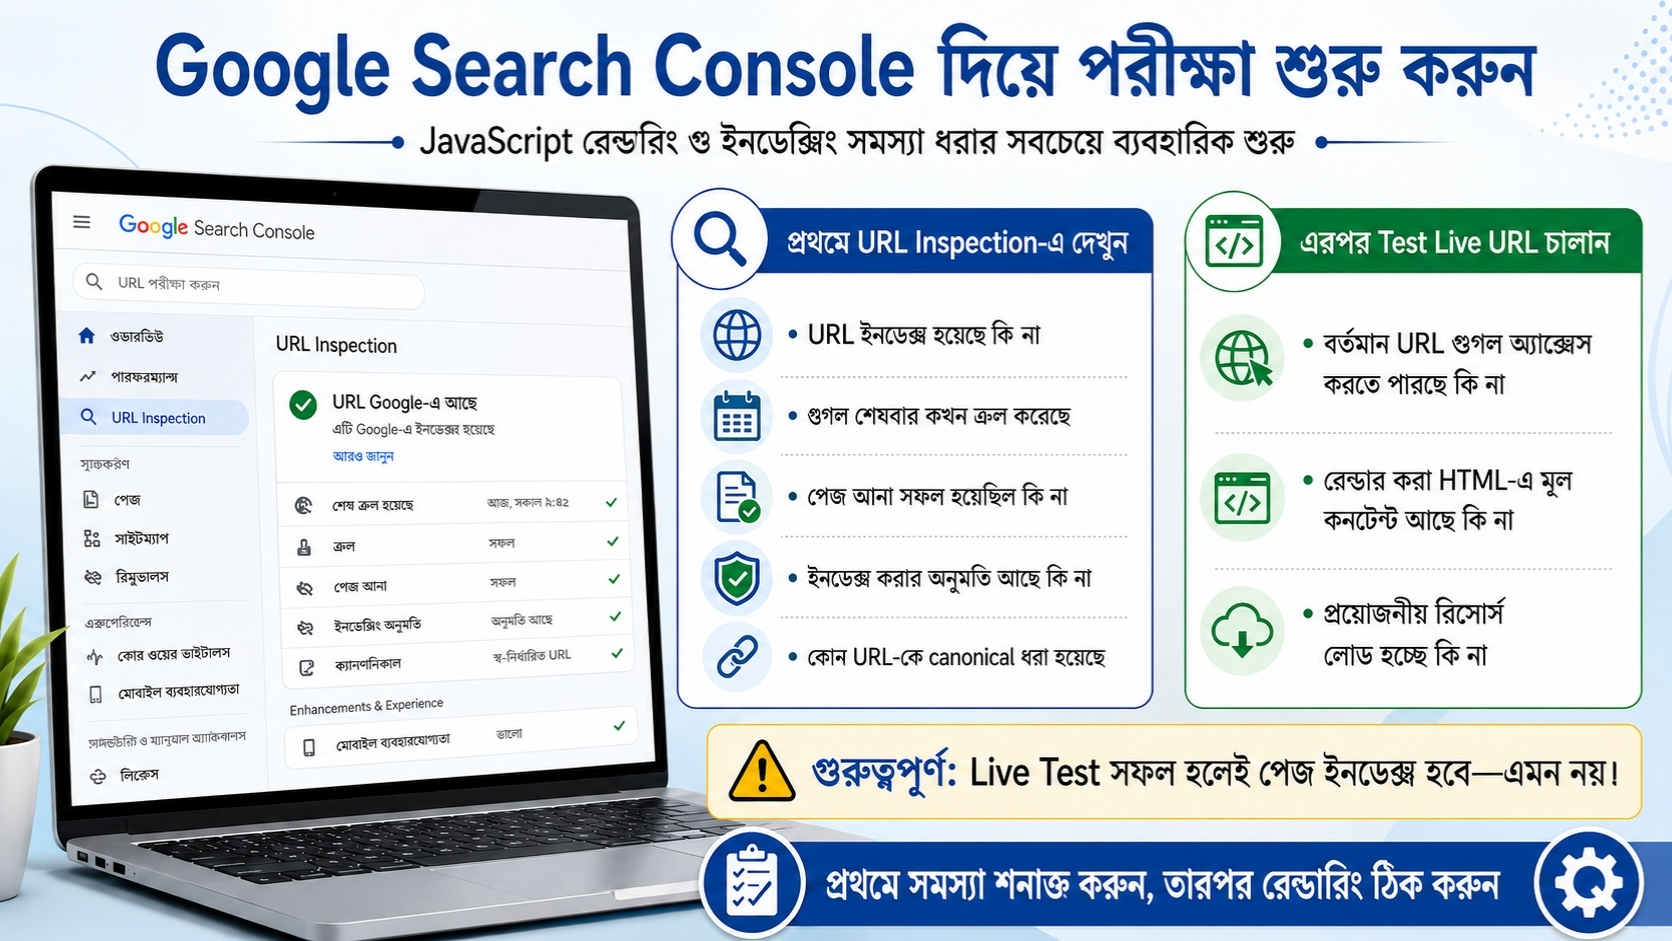
JavaScript রেন্ডারিং ও ইনডেক্সিং সমস্যা ধরার সবচেয়ে ব্যবহারিক জায়গা হলো Google Search Console-এর URL Inspection Tool।
এই টুলে Google index-এ থাকা URL-এর তথ্য দেখা যায়। একই সঙ্গে URL-এর বর্তমান সংস্করণ গুগল কীভাবে দেখতে পাচ্ছে, সেটিও আলাদাভাবে পরীক্ষা করা যায়।
প্রথমে ইনডেক্সে থাকা URL-এর অবস্থা দেখুন
Search Console-এর URL Inspection বারে সম্পূর্ণ URL দিন।
বিশেষভাবে দেখুন:
- URL ইনডেক্স হয়েছে কি না
- গুগল শেষবার কখন ক্রল করেছে
- পেজ আনা সফল হয়েছিল কি না
- ইনডেক্স করার অনুমতি আছে কি না
- গুগল কোন URL-কে canonical হিসেবে বেছে নিয়েছে
- ক্রল বা ইনডেক্স বন্ধ হওয়ার কোনো কারণ দেখানো হচ্ছে কি না
গুগল অন্য একটি URL-কে canonical হিসেবে বেছে নিলে আপনি যে URL পরীক্ষা করছেন, সেটি নিজে ইনডেক্সে নাও থাকতে পারে। একইভাবে noindex থাকলে রেন্ডারিংয়ের পদ্ধতি বদলালেও URL ইনডেক্স হবে না।
এই পর্যায়েই যদি স্পষ্ট ক্রলিং বা ইনডেক্সিং সমস্যা পাওয়া যায়, তাহলে সঙ্গে সঙ্গে React, Vue বা অন্য ফ্রেমওয়ার্কের রেন্ডারিং পদ্ধতি বদলানো যুক্তিসঙ্গত নয়।
আরও পড়ুন: Search Console Query থেকে নতুন Content Idea খুঁজবেন কীভাবে
এরপর বর্তমান URL পরীক্ষা করুন
Google index-এ থাকা তথ্য সব সময় পেজের বর্তমান অবস্থা দেখায় না। শেষ ক্রলের পর কোড বা কনটেন্ট পরিবর্তন করা হয়ে থাকলে Test Live URL চালান।
এই পরীক্ষা বর্তমান URL গুগলের পরীক্ষাব্যবস্থা অ্যাক্সেস ও প্রক্রিয়া করতে পারছে কি না বুঝতে সাহায্য করে।
তবে একটি বিষয় মনে রাখা জরুরি: Live Test সফল হলেই URL ইনডেক্স হয়েছে বা Google Search-এ দেখা যাবে—এমন নয়।
এই পরীক্ষা ইনডেক্সিংয়ের সব শর্ত যাচাই করে না। Manual action, duplicate বা canonical নির্বাচন, কনটেন্টের মান কিংবা অন্য ইনডেক্সিং সিদ্ধান্তের কারণে প্রযুক্তিগতভাবে ঠিক থাকা URL-ও ইনডেক্সের বাইরে থাকতে পারে।
তাই দুটি ফল পাশাপাশি দেখুন।
ইনডেক্সে থাকা সংস্করণ: গুগল আগের ক্রল বা ইনডেক্সিংয়ের সময় URL সম্পর্কে কী তথ্য রেখেছে।
বর্তমান পরীক্ষার সংস্করণ: এখন পরীক্ষা করলে গুগল URL থেকে কী পাচ্ছে।
পুরোনো সংস্করণে সমস্যা থাকলেও বর্তমান পরীক্ষা ঠিক থাকলে সংশোধিত পেজটি পরবর্তী ক্রলের জন্য ভালো অবস্থায় থাকতে পারে।
রেন্ডার করা HTML-এ মূল কনটেন্ট খুঁজুন
JavaScript SEO যাচাইয়ে শুধু স্ক্রিনশট দেখার চেয়ে রেন্ডার করা HTML পরীক্ষা করা বেশি গুরুত্বপূর্ণ।
Live Test-এর পর View Tested Page খুলে HTML ও স্ক্রিনশট দেখা যায়। ইনডেক্স হওয়া পেজের ক্ষেত্রে প্রয়োজন অনুযায়ী আগের ক্রলের তথ্যও দেখা যেতে পারে।
ধরা যাক একটি ই-কমার্স পেজে ব্রাউজারে দেখা যাচ্ছে:
- পণ্যের নাম
- দাম
- পণ্যের বিবরণ
- পণ্য পাওয়া যাচ্ছে কি না
- বিভাগে যাওয়ার লিংক
এখন রেন্ডার করা HTML খুলে পণ্যের নাম বা বিবরণের একটি স্বতন্ত্র অংশ খুঁজুন।
ব্রাউজারে কনটেন্ট থাকলেও গুগলের রেন্ডার করা HTML-এ সেটি না থাকলে রেন্ডারিং বা ডেটা লোড হওয়ার প্রক্রিয়ায় সমস্যা আছে কি না দেখতে হবে।
CSR অ্যাপ্লিকেশনে প্রাথমিক HTML এমন হতে পারে:
<div id=”app”></div>
<script src=”/app.js”></script>
এরপর JavaScript API থেকে তথ্য এনে পেজের কনটেন্ট তৈরি করে।
এই কাঠামো নিজে থেকেই Google Search-এর জন্য ভুল নয়। সমস্যা হয় যখন রেন্ডারিংয়ের সময় প্রয়োজনীয় JavaScript, API response বা অন্য কোনো রিসোর্স পাওয়া যায় না।
শুধু স্ক্রিনশট দেখে সিদ্ধান্ত নেবেন না
URL Inspection-এর স্ক্রিনশট কিছু দৃশ্যমান সমস্যা দ্রুত ধরতে পারে। যেমন:
- মূল কনটেন্টের জায়গা ফাঁকা
- কোনো পপ-আপ বা ওভারলে পুরো পেজ ঢেকে রেখেছে
- প্রয়োজনীয় অংশ লোড হয়নি
- পেজের বিন্যাস অস্বাভাবিক
- দরকারি ছবি বা অন্য রিসোর্স আসেনি
কিন্তু স্ক্রিনশট দিয়ে পুরো রেন্ডারিং অবস্থা বোঝা যায় না। কোনো লেখা স্ক্রিনশটের দৃশ্যমান অংশে না থাকলেও সেটি রেন্ডার করা HTML-এ থাকতে পারে।
তাই অন্তত চারটি বিষয় মিলিয়ে দেখুন:
- রেন্ডার করা HTML
- স্ক্রিনশট
- লোড হওয়া পেজ রিসোর্স
- JavaScript ত্রুটি বা exception
এগুলোর মধ্যে রেন্ডার করা HTML-এ প্রয়োজনীয় কনটেন্ট আছে কি না, সেটিকে অগ্রাধিকার দিন।
প্রয়োজনীয় JavaScript বা রিসোর্স বন্ধ আছে কি না দেখুন
Googlebot মূল HTML পেলেও রেন্ডারিংয়ের জন্য দরকারি JavaScript file বা অন্য প্রয়োজনীয় রিসোর্স আনতে না পারলে পেজ অসম্পূর্ণভাবে তৈরি হতে পারে।
সম্ভাব্য কারণের মধ্যে আছে:
- robots.txt-এ প্রয়োজনীয় রিসোর্স বন্ধ করা
- CDN বা WAF-এ বট-সংক্রান্ত বিধিনিষেধ
- লগইন বা অনুমতির প্রয়োজন
- API request ব্যর্থ হওয়া
- সার্ভারের ত্রুটি
- ভুল asset URL
উদাহরণ:
User-agent: Googlebot
Disallow: /assets/
যদি /assets/ directory-তে পেজ রেন্ডার করার জন্য প্রয়োজনীয় JavaScript থাকে, তাহলে এই নিয়ম সমস্যার কারণ হতে পারে।
এখানে আরও একটি পার্থক্য মনে রাখতে হবে: robots.txt দিয়ে ক্রল বন্ধ করা এবং noindex ব্যবহার করা এক বিষয় নয়।
robots.txt Googlebot-কে কোনো URL বা রিসোর্স ক্রল করা থেকে বিরত রাখতে পারে। কোনো পেজকে ইনডেক্স না করার নির্দেশ দেওয়ার পদ্ধতি আলাদা।
CSR সাইটে অভ্যন্তরীণ লিংক সত্যিই ক্রলযোগ্য কি না দেখুন
JavaScript দিয়ে কোনো উপাদান ক্লিকযোগ্য করা এবং গুগলের জন্য ক্রলযোগ্য লিংক তৈরি করা এক জিনিস নয়।
URL খুঁজে পাওয়ার জন্য <a> element-এর সঙ্গে href ব্যবহার করা বেশি নির্ভরযোগ্য।
সঠিক উদাহরণ:
<a href=”/products/laptop”>ল্যাপটপ দেখুন</a>
এর বিপরীতে শুধু এমন পদ্ধতির ওপর নির্ভর করা উচিত নয়:
<div onclick=”openProduct()”>ল্যাপটপ দেখুন</div>
JavaScript দিয়ে DOM-এর মধ্যে লিংক তৈরি করা হলেও সেটি ক্রলযোগ্য <a href> হলে গুগল সেটি খুঁজে পেতে পারে।
Single Page Application-এর routing-এর ক্ষেত্রেও fragment-নির্ভর URL-এর বদলে History API এবং স্বাভাবিক URL কাঠামো ব্যবহার করা ভালো।
যেমন:
/products/laptop
এ ধরনের URL #/products/laptop-নির্ভর কাঠামোর তুলনায় Search-এর জন্য পরিষ্কার।
Lazy loading-এ গুরুত্বপূর্ণ কনটেন্ট হারাচ্ছে কি না দেখুন
Infinite scroll, পণ্যের তালিকা বা দীর্ঘ নিবন্ধে রেন্ডারিং সমস্যা সব সময় ফ্রেমওয়ার্কের কারণে হয় না। অনেক সময় lazy loading কীভাবে তৈরি করা হয়েছে, সেখানেই সমস্যা থাকে।
Google Search ব্যবহারকারীর মতো পেজে ক্লিক করে বা অন্যান্য কাজ করে কনটেন্ট খুঁজে বের করার ওপর নির্ভর করে না। গুরুত্বপূর্ণ কনটেন্ট যদি কোনো বোতামে ক্লিক বা অন্য ব্যবহারকারী-নির্ভর কাজের পর লোড হয়, গুগল সেটি নাও পেতে পারে।
Lazy loading ব্যবহার করা হলে দেখুন:
- দৃশ্যমান অংশে এলে কনটেন্ট নিজে থেকে লোড হচ্ছে কি না
- browser-native lazy loading বা IntersectionObserver ব্যবহার করা হয়েছে কি না
- Infinite scroll-এর গুরুত্বপূর্ণ অংশগুলোর আলাদা URL আছে কি না
- pagination URL-গুলোর মধ্যে ক্রলযোগ্য লিংক আছে কি না
Infinite scroll থাকলে গুরুত্বপূর্ণ প্রতিটি কনটেন্ট অংশের স্থায়ী URL রাখা বেশি নির্ভরযোগ্য। নতুন অংশ প্রধান দৃশ্য হিসেবে এলে History API দিয়ে URL-ও হালনাগাদ করা যেতে পারে।
মোবাইল সংস্করণ আলাদাভাবে পরীক্ষা করুন
Googlebot Smartphone এবং Googlebot Desktop—দুই ধরনের crawler থাকলেও Google Search অধিকাংশ ওয়েবসাইটের ক্ষেত্রে মোবাইল সংস্করণকে ইনডেক্সিংয়ের প্রধান ভিত্তি হিসেবে ব্যবহার করে।
তাই শুধু ডেস্কটপ ব্রাউজারে পেজ ঠিক দেখালেই পরীক্ষা শেষ নয়।
মোবাইল সংস্করণে দেখুন:
- মূল কনটেন্ট পাওয়া যাচ্ছে কি না
- নেভিগেশনের গুরুত্বপূর্ণ লিংক ক্রলযোগ্য কি না
- responsive component প্রয়োজনীয় কনটেন্ট বাদ দিচ্ছে কি না
- CDN বা নিরাপত্তা ব্যবস্থা মোবাইল crawler-এর request আলাদাভাবে বন্ধ করছে কি না
এখানে মোবাইল ডিজাইন দেখতে কতটা সুন্দর, সেটি JavaScript SEO-এর মূল প্রশ্ন নয়। গুগলের মোবাইল crawler প্রয়োজনীয় কনটেন্ট ও রিসোর্স পাচ্ছে কি না, সেটিই আগে দেখুন।
সমস্যাটি কোন পর্যায়ে, দ্রুত বুঝবেন যেভাবে
| যা দেখা যাচ্ছে | সম্ভাব্য সমস্যা | প্রথমে পরীক্ষা করুন |
| গুগল URL আনতে পারছে না | ক্রলিং | robots.txt, HTTP response, সার্ভার |
| বর্তমান পরীক্ষা ঠিক, কিন্তু indexed data পুরোনো | পুনরায় ক্রল বা index update | last crawl, Request Indexing |
| ব্রাউজারে লেখা আছে, rendered HTML-এ নেই | রেন্ডারিং | JavaScript ত্রুটি, API, রিসোর্স |
| Rendered HTML ঠিক, URL index হয়নি | ইনডেক্সিং | noindex, canonical, duplicate |
| URL index হয়েছে, কিন্তু ভালো rank করছে না | র্যাংকিং বা প্রাসঙ্গিকতা | কনটেন্ট, search intent, internal linking |
| Infinite scroll-এর content পাওয়া যাচ্ছে না | Lazy loading | interaction, pagination, URL কাঠামো |
এই পার্থক্যটি আগে বুঝতে পারলে অপ্রয়োজনীয়ভাবে পুরো রেন্ডারিং ব্যবস্থা বদলানোর ঝুঁকি কমে।
কখন Server-Side Rendering বিবেচনা করবেন
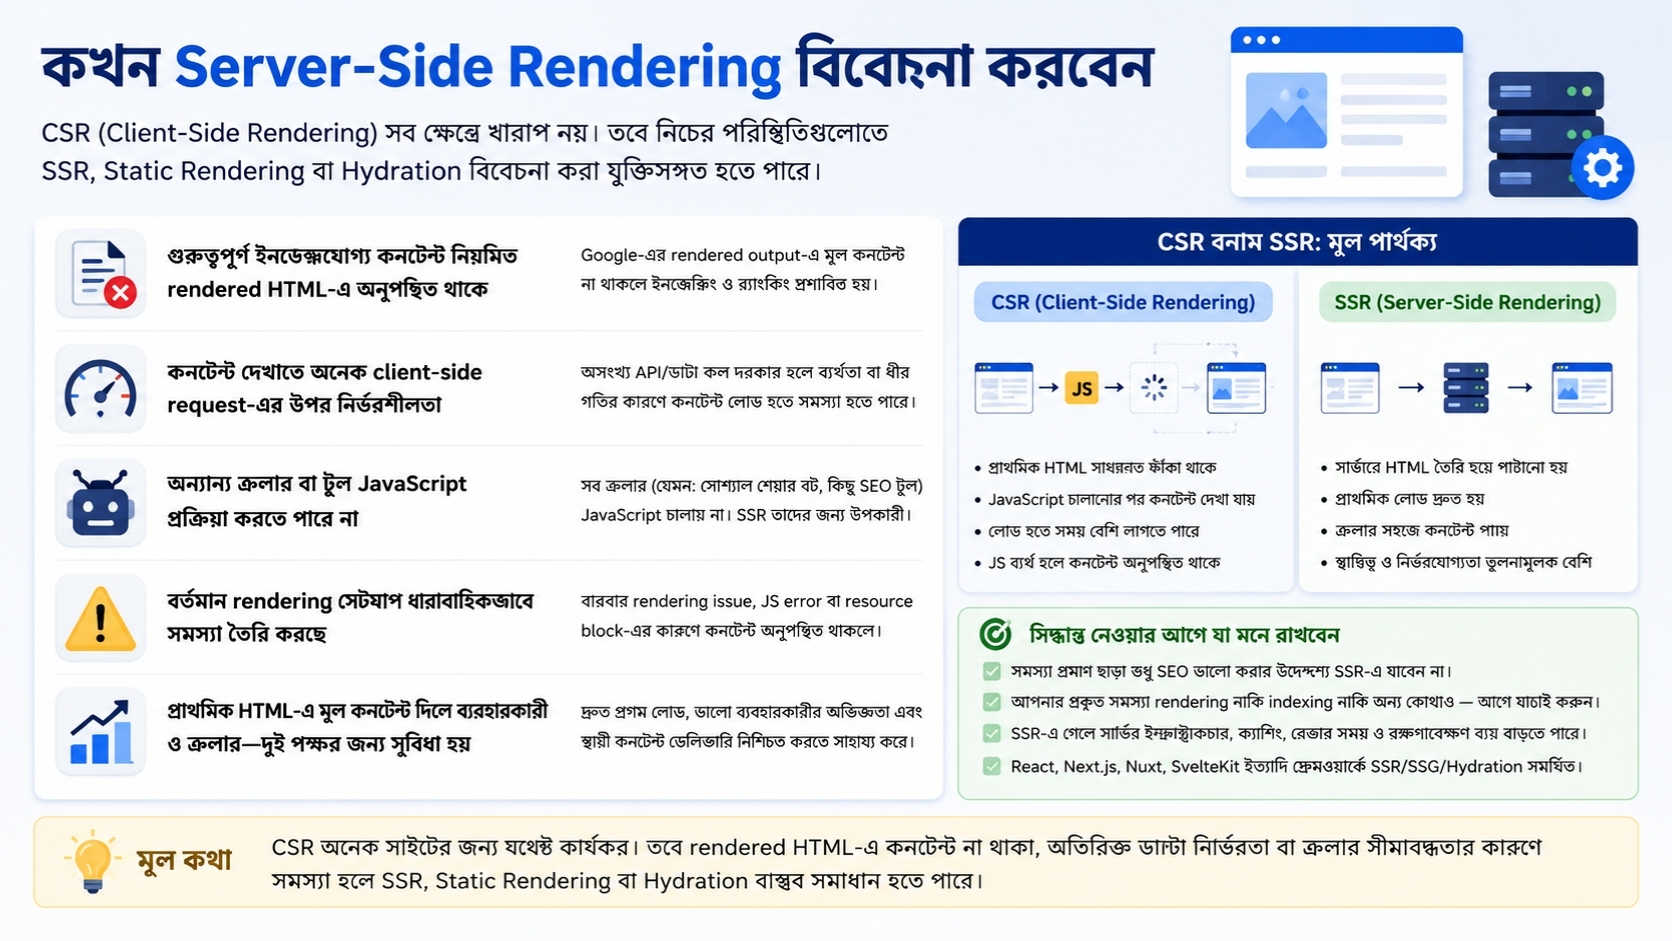
Client-Side Rendering ব্যবহার করলেই Server-Side Rendering (SSR)-এ চলে যেতে হবে—এমন নিয়ম নেই। Google JavaScript রেন্ডার করতে পারে।
তবে কাঠামো পরিবর্তন বিবেচনা করা যেতে পারে যদি:
- গুরুত্বপূর্ণ ইনডেক্সযোগ্য কনটেন্ট নিয়মিত rendered HTML-এ অনুপস্থিত থাকে
- কনটেন্ট দেখাতে অনেক client-side request-এর ওপর নির্ভর করতে হয় এবং সেগুলো ব্যর্থ হচ্ছে
- প্রয়োজনীয় অন্য crawler JavaScript প্রক্রিয়া করতে পারে না
- বর্তমান rendering setup ধারাবাহিকভাবে সমস্যা তৈরি করছে
- প্রাথমিক HTML-এ মূল কনটেন্ট দেওয়া ব্যবহারকারী ও crawler—দুই পক্ষের জন্য সুবিধাজনক হয়
Google server-side rendering বা pre-rendering-কে গ্রহণযোগ্য পদ্ধতি হিসেবে উল্লেখ করে।
তবে SSR ব্যবহার করলেই সাইট স্বয়ংক্রিয়ভাবে দ্রুত বা SEO-বান্ধব হয়ে যাবে, এমন সিদ্ধান্ত ঠিক নয়। গতি নির্ভর করবে সার্ভারের response time, caching, JavaScript-এর আকার, hydration এবং পুরো সাইটের কাঠামোর ওপর।
তাই rendering সমস্যার প্রমাণ না পেয়ে শুধু JavaScript SEO উন্নত করার জন্য SSR-এ চলে যাওয়া অপ্রয়োজনীয় উন্নয়নকাজ তৈরি করতে পারে।
Dynamic Rendering-কে নতুন দীর্ঘমেয়াদি সমাধান হিসেবে নেবেন না
Dynamic Rendering-এ crawler-এর জন্য server-rendered version এবং ব্যবহারকারীর জন্য client-rendered version দেওয়া হয়।
Google এখন এটিকে দীর্ঘমেয়াদি সমাধান হিসেবে সুপারিশ করে না। এটি মূলত একটি সাময়িক বিকল্প পদ্ধতি বা workaround।
নতুন সাইটে server-side rendering, static rendering বা hydration-এর মতো পদ্ধতিকে অগ্রাধিকার দেওয়া বেশি যুক্তিসঙ্গত।
Dynamic Rendering ব্যবস্থায় বাড়তি প্রযুক্তিগত জটিলতা ও রক্ষণাবেক্ষণের প্রয়োজন হতে পারে।
পুরোনো কোনো সাইটে এটি আগে থেকেই চালু থাকলে সরাসরি বন্ধ করার বদলে নতুন ব্যবস্থায় যাওয়ার সময় নিশ্চিত করুন:
- crawler ও ব্যবহারকারী একই মূল কনটেন্ট পাচ্ছে
- metadata সঠিক আছে
- canonical signal বদলায়নি
- HTTP response ঠিক আছে
পরিবর্তনের পর একই পরীক্ষা আবার করুন
সমস্যার সমাধান প্রকাশ করার পর একই URL আবার Test Live URL দিয়ে পরীক্ষা করুন।
দেখুন:
- প্রয়োজনীয় লেখা rendered HTML-এ এসেছে কি না
- দরকারি রিসোর্স লোড হচ্ছে কি না
- JavaScript ত্রুটি আছে কি না
- HTTP status সঠিক কি না
- ইনডেক্স করার অনুমতি আছে কি না
- canonical প্রত্যাশামতো আছে কি না
- ক্রলযোগ্য internal link পাওয়া যাচ্ছে কি না
সব ঠিক থাকলে Search Console থেকে Request Indexing ব্যবহার করা যেতে পারে।
তবে এটি URL ইনডেক্স করার নির্দেশ নয়; গুগলকে URL-টি আবার পরীক্ষা করার অনুরোধ মাত্র। URL ইনডেক্স হবে বা Search results-এ দেখা যাবে—এমন নিশ্চয়তা নেই।
অনেক URL পরিবর্তন করা হলে প্রতিটির জন্য আলাদাভাবে Request Indexing পাঠানোর বদলে sitemap ঠিক রাখা বেশি বাস্তবসম্মত।
বড় সাইটে একটি URL দেখে সিদ্ধান্ত না নিয়ে একই template-এর কয়েক ধরনের পেজ পরীক্ষা করুন। যেমন:
- নিবন্ধের পেজ
- বিভাগীয় পেজ
- পণ্যের পেজ
- pagination পেজ
Search Console-এর Crawl Stats রিপোর্ট Googlebot ও Web Rendering Service-এর কার্যক্রম বোঝার ক্ষেত্রেও কাজে লাগতে পারে।
সমস্যা হলে প্রথমে কী পরীক্ষা করবেন
JavaScript ওয়েবসাইট Google-এ প্রত্যাশামতো দেখা না গেলে পুরো কাঠামো বদলানোর আগে এই ক্রমে পরীক্ষা করুন:
- URL Inspection-এ ক্রলিং ও ইনডেক্সিংয়ের অবস্থা দেখুন।
- Test Live URL চালান।
- Rendered HTML-এ মূল কনটেন্ট খুঁজুন।
- JavaScript ত্রুটি ও প্রয়োজনীয় রিসোর্স পরীক্ষা করুন।
- HTTP status, robots.txt, noindex ও canonical মিলিয়ে দেখুন।
- CSR-ই সমস্যার কারণ প্রমাণিত হলে SSR, static rendering বা hydration বিবেচনা করুন।
সবচেয়ে গুরুত্বপূর্ণ পার্থক্যটি হলো, র্যাংক না করা এবং রেন্ডারিং ব্যর্থ হওয়া একই বিষয় নয়।
Google rendered HTML-এ প্রয়োজনীয় কনটেন্ট পেলে এবং ক্রলিং ও ইনডেক্সিংয়ের সংকেত ঠিক থাকলে সমস্যাটি canonical নির্বাচন, duplicate content, internal linking, কনটেন্টের মান বা search query-এর সঙ্গে প্রাসঙ্গিকতার মতো অন্য জায়গায় থাকতে পারে।
তাই কার্যকর JavaScript SEO রেন্ডারিং যাচাই ফ্রেমওয়ার্ক বদলানো দিয়ে শুরু করা উচিত নয়। আগে বের করুন, গুগলের প্রক্রিয়ার কোন পর্যায়ে পেজটি আটকে যাচ্ছে—ক্রলিং, রেন্ডারিং, ইনডেক্সিং, নাকি র্যাংকিং।
শেষ কথা
JavaScript SEO সমস্যা সমাধানের ক্ষেত্রে সবচেয়ে কার্যকর পদ্ধতি হলো অনুমান না করে ধাপে ধাপে প্রমাণ দেখা। কোনো পেজ র্যাংক করছে না মানেই rendering ব্যর্থ—এমন সিদ্ধান্তে যাওয়া ঠিক নয়। আগে URL Inspection, live test এবং rendered HTML দেখে নিশ্চিত করুন Google আসলে কী পাচ্ছে।
যদি মূল কনটেন্ট, canonical, robots নির্দেশনা এবং crawlable link ঠিক থাকে, তাহলে সমস্যা rendering-এর বাইরে অন্য SEO সংকেতেও থাকতে পারে। আর যদি rendered HTML-এই প্রয়োজনীয় কনটেন্ট অনুপস্থিত থাকে, তখন CSR implementation, blocked resource বা rendering architecture পরীক্ষা করা যুক্তিসঙ্গত।
ব্যবহারিকভাবে, JavaScript SEO rendering audit-এর সেরা শুরু হলো সমস্যার স্তর চিহ্নিত করা—crawl, render, index নাকি rank। এই পার্থক্য পরিষ্কার হলে অপ্রয়োজনীয় redesign বা SSR migration এড়িয়ে অনেক দ্রুত সঠিক সমাধানে পৌঁছানো যায়।
প্রায়শই জিজ্ঞাসিত প্রশ্ন
1. Google কি JavaScript দিয়ে তৈরি ওয়েবসাইট ইনডেক্স করতে পারে?
হ্যাঁ। Google JavaScript চালিয়ে rendered HTML থেকে কনটেন্ট প্রক্রিয়া করতে পারে। তবে প্রয়োজনীয় JavaScript file, API data বা অন্যান্য resource Googlebot-এর জন্য accessible না হলে গুরুত্বপূর্ণ কনটেন্ট rendering-এর সময় অনুপস্থিত থাকতে পারে।
2. URL Inspection-এর Live Test সফল হলে কি পেজ অবশ্যই ইনডেক্স হবে?
না। Live Test সফল হওয়া মানে Google বর্তমান URL access ও process করতে পারছে। কিন্তু canonical নির্বাচন, noindex, duplicate content, quality-related বিষয় বা অন্য indexing decision-এর কারণে URL ইনডেক্সে নাও আসতে পারে।
3. JavaScript SEO সমস্যার জন্য কি SSR ব্যবহার করতেই হবে?
না। Client-Side Rendering ব্যবহার করলেই Server-Side Rendering (SSR)-এ যেতে হবে এমন নিয়ম নেই। আগে rendered HTML পরীক্ষা করে নিশ্চিত করুন JavaScript rendering-ই সমস্যার কারণ কি না। প্রয়োজনীয় কনটেন্ট নিয়মিত অনুপস্থিত থাকলে SSR, static rendering বা hydration বিবেচনা করা যেতে পারে।