
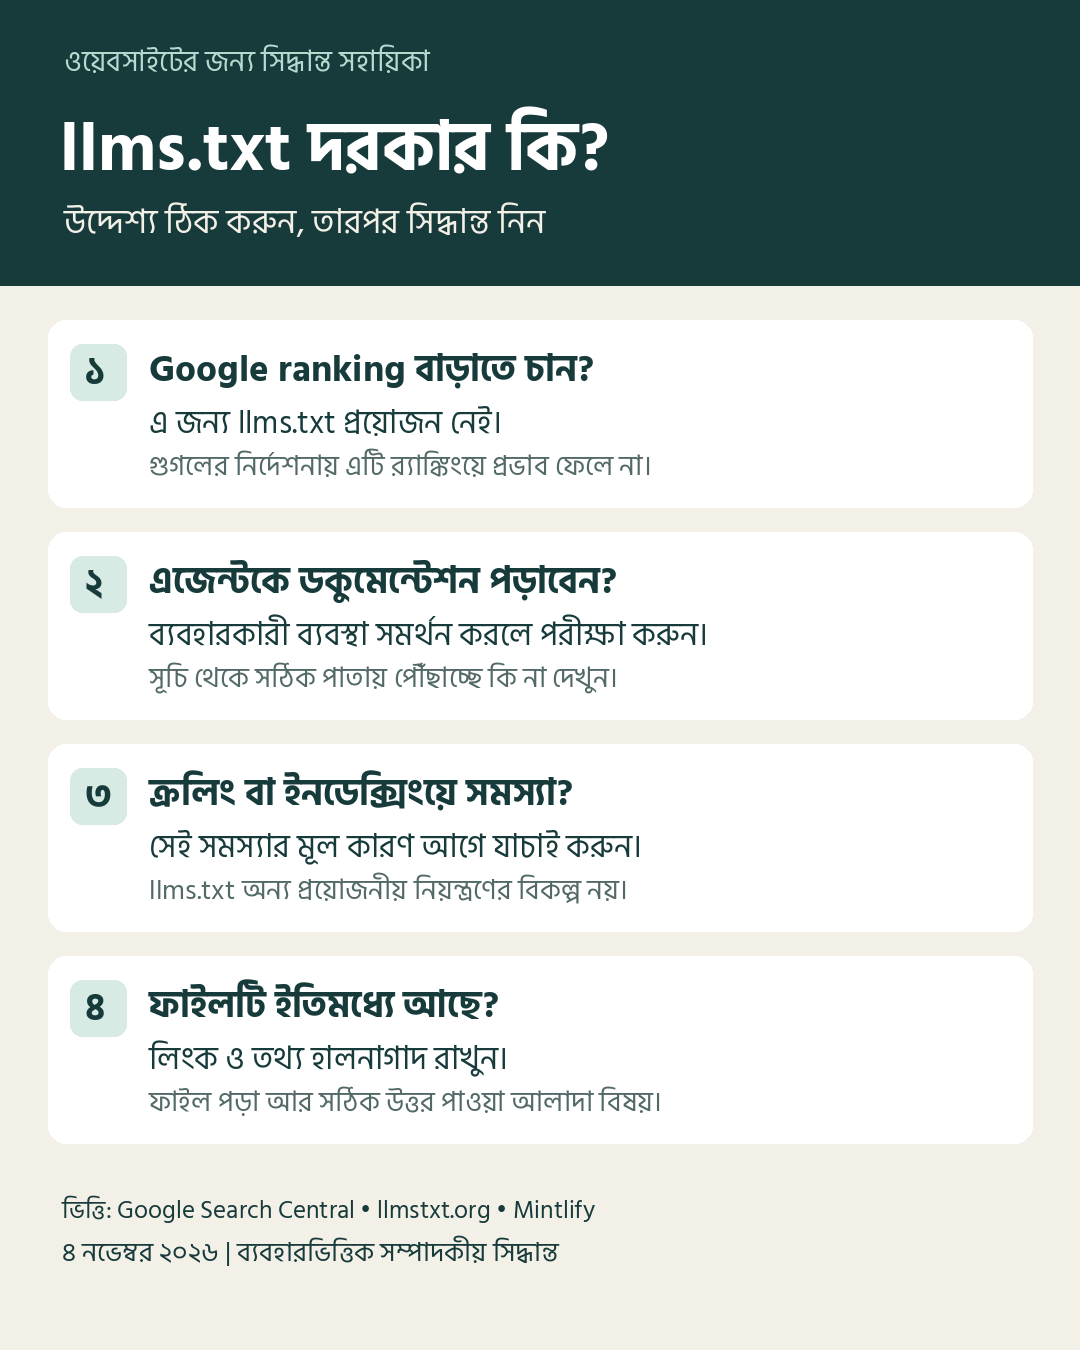
শুধু Google Search-এ র্যাঙ্ক বাড়ানোর জন্য llms.txt তৈরি করার প্রয়োজন নেই। কিন্তু কোনো AI এজেন্টকে আপনার সফটওয়্যারের ডকুমেন্টেশন বা নির্দিষ্ট তথ্য খুঁজে পেতে সাহায্য করতে চাইলে ফাইলটি বিবেচনার জায়গা আছে। এই দুই উদ্দেশ্যকে এক করে ফেললেই ভুল প্রত্যাশা তৈরি হয়।
নামের বিষয়টিও শুরুতে পরিষ্কার করা দরকার। আলোচিত প্রস্তাবের ফাইলনাম llms.txt—ছোট হাতের অক্ষরে, শেষে s-সহ। শিরোনামে ব্যবহৃত “LLM.txt” দিয়ে এখানে সেই ফাইলটিকেই বোঝানো হচ্ছে।
৪ নভেম্বর ২০২৬ পর্যন্ত যাচাই করা মূল নথিগুলো থেকে সবচেয়ে ব্যবহারযোগ্য সিদ্ধান্ত হলো: আগে ঠিক করুন, কোন ব্যবস্থাকে কোন তথ্য পড়াতে চান। তারপর দেখুন সেই কাজে ফাইলটির ভূমিকা আছে কি না।
গুগলে দৃশ্যমানতার জন্য এটি দরকার নেই
Google Search Central-এর জেনারেটিভ AI অপ্টিমাইজেশন নির্দেশনা সরাসরি জানিয়েছে, Google Search llms.txt ব্যবহার করে না। এটি রাখলে Google Search-এ সাইটের দৃশ্যমানতা বা র্যাঙ্কিংয়ের ইতিবাচক কিংবা নেতিবাচক পরিবর্তন হয় না। অন্য কোনো ব্যবস্থা ফাইলটি ব্যবহার করলে তার জন্য রাখা যেতে পারে।
এখানে একটি সূক্ষ্ম পার্থক্য আছে। গুগল কোনো টেক্সট ফাইল আবিষ্কার, ক্রল বা ইনডেক্স করতে পারলেই সেটিকে বিশেষ নির্দেশনা হিসেবে ব্যবহার করছে—এমন নয়। ফলে সার্ভার লগে ফাইলটির অনুরোধ দেখা বা সার্চে তার URL পাওয়া, কোনোটিই বাড়তি SEO সুবিধার প্রমাণ নয়।
AI Overviews ও AI Mode-এর ক্ষেত্রে গুগলের ওয়েবসাইটবিষয়ক নির্দেশনা অনুযায়ী, সহায়ক লিংক হিসেবে দেখানোর যোগ্য হতে পেজটি ইনডেক্সড এবং সার্চে স্নিপেটসহ দেখানোর উপযুক্ত হতে হয়। আলাদা AI টেক্সট ফাইল লাগে না; যোগ্যতা পূরণ করলেও দেখানো নিশ্চিত নয়।
আপনার গুরুত্বপূর্ণ লেখা ইনডেক্স হচ্ছে না, ভেতরের লিংক দুর্বল বা পেজের মূল তথ্য পড়া যাচ্ছে না—এ অবস্থায় llms.txt যোগ করাকে প্রধান সমাধান ধরে নেওয়া ঠিক হবে না। আগে প্রকাশের আগের অন-পেজ এসইও যাচাই এবং সাইটের প্রকৃত সমস্যাগুলোতে মন দিন।
তাহলে ফাইলটির কাজ কী?
মূল প্রস্তাবে llms.txt হলো Markdown-এ লেখা সংক্ষিপ্ত পরিচিতি ও প্রয়োজনীয় তথ্যের পথনির্দেশ। সাইটের নাম, বিষয়বস্তুর সারাংশ এবং বাছাই করা পাতার লিংক এখানে সাজানো যায়। উদ্দেশ্য হলো, কোনো এজেন্টকে পুরো সাইট ঘুরে আন্দাজ করার বদলে প্রাসঙ্গিক তথ্যের দিকে যেতে সাহায্য করা।
ধরা যাক, একটি সফটওয়্যারের ডকুমেন্টেশনে ইনস্টলেশন, API সীমা এবং ত্রুটি সমাধানের আলাদা পাতা আছে। ব্যবহারকারী নির্দিষ্ট ত্রুটির ব্যাখ্যা চাইলে একটি সুবিন্যস্ত সূচি এজেন্টকে সঠিক পাতাটি বেছে নিতে সাহায্য করতে পারে। এটি সম্ভাব্য ব্যবহার বোঝানোর উদাহরণ; কোনো নির্দিষ্ট সাইটে মাপা ফল নয়।
Jeremy Howard-এর প্রস্তাবটি প্রথম প্রকাশিত হয় ৩ সেপ্টেম্বর ২০২৪। ২০২৬ সালের আগস্টের সংশোধনে পাতার Markdown সংস্করণ এবং সংশ্লিষ্ট llms.txt খুঁজে পাওয়ার জন্য লিংক সম্পর্কের নির্দেশনা যোগ হয়েছে। কোনো উপপথের ফাইল কোন পাতাগুলোকে অন্তর্ভুক্ত করে, সেটিও স্পষ্ট করা হয়েছে।
এই পরিবর্তন প্রস্তাবের অগ্রগতি দেখায়। তবে একটি প্রকাশনা-পদ্ধতির উন্নতি থেকে সব AI পণ্য একইভাবে সেটি পড়বে—এ সিদ্ধান্ত নেওয়া যায় না।
ব্যবহার আছে, কিন্তু ফলের দাবি আলাদা করে বিচার করতে হবে
ডকুমেন্টেশন প্ল্যাটফর্ম Mintlify-এর নিজস্ব নথিতে স্বয়ংক্রিয়ভাবে llms.txt ও llms-full.txt তৈরির সুবিধা রয়েছে। প্রথমটি পাতার সূচি হিসেবে কাজ করে; দ্বিতীয়টিতে ডকুমেন্টেশনের পূর্ণ পাঠ একসঙ্গে থাকে। এটি বাস্তব প্রকাশনা-সুবিধার উদাহরণ।
Mintlify-এর এজেন্ট দিয়ে ডকুমেন্টেশন খোঁজার নির্দেশনা আরও একটি প্রয়োজনীয় সীমা তুলে ধরে: সূচি পেলে এজেন্টকে সংশ্লিষ্ট লিংক অনুসরণ করে আসল তথ্য পড়তে হয়। বড় llms-full.txt ফাইল আবার ব্যবস্থার গ্রহণযোগ্য পাঠের সীমা ছাড়িয়ে যেতে পারে বা অপ্রাসঙ্গিক তথ্য নিয়ে আসতে পারে।
তাই তিনটি বিষয় আলাদা করে দেখুন:
- প্রকাশ: আপনার সাইটে ফাইলটি আছে এবং খোলা যায়।
- ব্যবহার: নির্দিষ্ট এজেন্ট সেটি পড়ে প্রয়োজনীয় পাতায় যাচ্ছে।
- ফল: সেই তথ্য থেকে সঠিক উত্তর তৈরি হচ্ছে বা প্রাসঙ্গিক উদ্ধৃতি আসছে।
প্রথমটির প্রমাণ দিয়ে পরের দুটির সাফল্য দাবি করা যায় না। একইভাবে কোনো প্ল্যাটফর্ম ফাইলটি তৈরি করে দিলেই সব চ্যাটবটের উত্তরে আপনার সাইট স্থান পাবে—এমন প্রতিশ্রুতিও সমর্থিত হয় না।
robots.txt ও sitemap.xml-এর সঙ্গে গুলিয়ে ফেলবেন না
| ফাইল | প্রধান ভূমিকা | যে নিশ্চয়তা দেয় না |
|---|---|---|
robots.txt |
নিয়ম মানা ক্রলারকে কোথায় ক্রল করতে দেওয়া হচ্ছে, তা জানানো | ব্যক্তিগত তথ্য সুরক্ষা বা সব URL সার্চ থেকে বাদ দেওয়া |
sitemap.xml |
সার্চ ইঞ্জিনকে গুরুত্বপূর্ণ URL ও সংশ্লিষ্ট তথ্য জানানো | সব পেজ ক্রল বা ইনডেক্স হওয়া |
llms.txt |
ব্যবহারকারী এজেন্টকে বাছাই করা তথ্যের পরিচিতি ও লিংক দেওয়া | Google ranking, সব AI-এর ব্যবহার বা citation |
গুগলের robots.txt নির্দেশনা অনুযায়ী, ক্রল বন্ধ করা URL-ও অন্য জায়গা থেকে লিংক পেলে সার্চে দেখা যেতে পারে। সংবেদনশীল তথ্যের সুরক্ষার জন্য যথাযথ প্রবেশাধিকার নিয়ন্ত্রণ দরকার। আর সাইটম্যাপ নির্দেশনা বলছে, সাইটম্যাপ URL আবিষ্কারে সহায়তা করে, ইনডেক্সিং নিশ্চিত করে না।
এই পার্থক্য থেকে ব্যবহারিক সিদ্ধান্তটি পরিষ্কার: llms.txt দিয়ে অন্য দুই ফাইলের কাজ প্রতিস্থাপনের পরিকল্পনা করবেন না। এতে “আমার তথ্য দিয়ে প্রশিক্ষণ নয়” লিখেও সব প্রতিষ্ঠানের জন্য কার্যকর নিষেধাজ্ঞা প্রতিষ্ঠিত হয়েছে বলে ধরে নেবেন না। প্রশিক্ষণ, সার্চ এবং ব্যবহারকারীর অনুরোধে তথ্য আনার নীতি এক বিষয় নয়; সংশ্লিষ্ট সেবার নিজস্ব নিয়ন্ত্রণ যাচাই করতে হবে।
কোন সাইটে আগে বিবেচনা করবেন
এখানে অগ্রাধিকারের সিদ্ধান্তটি সম্পাদকীয় মূল্যায়ন; কোনো পরীক্ষায় পাওয়া র্যাঙ্কিং নয়।
API বা সফটওয়্যার ডকুমেন্টেশন থাকলে ছোট পরিসরে পরীক্ষা করার যুক্তি আছে। বিশেষ করে ব্যবহারকারী এজেন্টকে আপনার নির্দিষ্ট সংস্করণের নির্দেশনা পড়াতে চাইলে। প্রয়োজনীয় পাতা খুঁজে পাওয়াই তখন মাপার মতো কাজ।
সাধারণ সংবাদ বা ব্লগ সাইট হলে আগে মৌলিক প্রকাশনা ও SEO সমস্যা দেখুন। শুধু AI-তে নাম আসবে, এই আশায় বড় ডেভেলপমেন্ট ব্যয় করার ভিত্তি এই গবেষণায় পাওয়া যায়নি। তবে কোনো নির্দিষ্ট অংশীদার বা নিজস্ব সহায়ক ব্যবস্থা ফাইলটি ব্যবহার করলে সেই প্রয়োজন আলাদা।
সাইটের নিজস্ব AI সহকারী থাকলে ডেভেলপারকে প্রথমে জিজ্ঞেস করুন, সহকারী কোন উৎস থেকে তথ্য নেয়। ডেটাবেস বা নিজস্ব অনুসন্ধানব্যবস্থা থেকে তথ্য নিলে আলাদা টেক্সট ফাইল প্রয়োজন কি না, তা ওই ব্যবস্থার নকশার ওপর নির্ভর করবে।
আর ইতিমধ্যে ফাইলটি থাকলে আতঙ্কে সরানোরও কারণ নেই। সেটি নির্ভুল কি না, কোথাও পুরোনো তথ্য দিচ্ছে কি না এবং রাখার দায়িত্ব কার—এসব দেখুন। Google ranking-এর জন্য বাড়তি সুবিধা না থাকাই ফাইল মুছে দেওয়ার স্বয়ংক্রিয় কারণ নয়।
রাখলে ছোট, নির্ভুল এবং পরীক্ষাযোগ্য রাখুন
শুরুতে সব প্রকাশিত লেখা একত্র করার বদলে একটি নির্দিষ্ট ব্যবহার বেছে নিন। যেমন, নতুন ব্যবহারকারীকে সঠিক ইনস্টলেশন গাইডে পৌঁছে দেওয়া। নিচের নমুনাটি শুধু কাঠামো বোঝানোর জন্য; example.com-এর ঠিকানাগুলো নিজের বাস্তব পাতার ঠিকানা দিয়ে বদলাতে হবে।
# Example Product Docs

> পণ্যটির প্রকাশ্য ব্যবহার নির্দেশনা ও API ডকুমেন্টেশন।

## শুরু করুন
- [ইনস্টলেশন](https://example.com/docs/install): প্রথমবার সেটআপের নির্দেশনা।

## সহায়তা
- [API সীমা](https://example.com/docs/limits): প্রযোজ্য সীমা ও শর্ত।
- [ত্রুটি সমাধান](https://example.com/docs/errors): পরিচিত ত্রুটির ব্যাখ্যা।
এরপর বিষয়বস্তু দেখে কয়েকটি বাস্তব প্রশ্ন ঠিক করুন। পরীক্ষায় লিখে রাখুন, কোন এজেন্ট ও সংস্করণ ব্যবহার করেছেন, কী নির্দেশ দিয়েছেন, কোন পাতায় পৌঁছেছে এবং উত্তরের কোন অংশ মূল নথির সঙ্গে মিলেছে। শুধু ফাইলটির URL দিয়ে পরীক্ষা করলে সেটি নির্দেশিত ব্যবহার; এজেন্ট নিজে থেকে ফাইলটি খুঁজে পেয়েছে—এমন দাবি করা যাবে না।
সম্ভব হলে একই প্রশ্ন ফাইলটির লিংক দিয়ে ও না দিয়ে একাধিকবার পরীক্ষা করুন। এটি স্থানীয় ব্যবহারের তুলনা হতে পারে; উন্মুক্ত সার্চে র্যাঙ্কিং পরিবর্তনের কারণ প্রমাণ করবে না।
প্রকাশের পরে ভাঙা লিংক, পুরোনো সংস্করণ এবং মূল পাতার সঙ্গে সারাংশের অমিল দেখার দায়িত্ব দিন। প্রকাশ্য ফাইলে গোপন কী, গ্রাহকের তথ্য বা অপ্রকাশিত নথি রাখবেন না। AI-এর উত্তরও মূল উৎস মিলিয়ে যাচাই করুন; সূচি থাকার অর্থ উত্তর নির্ভুল হওয়া নয়।
llms.txt রাখার সবচেয়ে ভালো কারণ হলো, আপনার নির্দিষ্ট তথ্য ব্যবহারের একটি বাস্তব প্রয়োজন আছে। শুধু ফাইলটি না থাকলে AI আপনাকে চিনবে না—এ ভয় থেকে কাজ শুরু করার প্রয়োজন নেই। আগে তথ্যের মান, পরে সেটি খুঁজে পাওয়ার পথ; সেই পথে ফাইলটি সাহায্য করছে কি না, পরীক্ষা করে সিদ্ধান্ত নিন।